Naive-N0.5-Flash NaiveAI 开源的首个 MoE 大模型
Naive-N0.5-Flash是什么
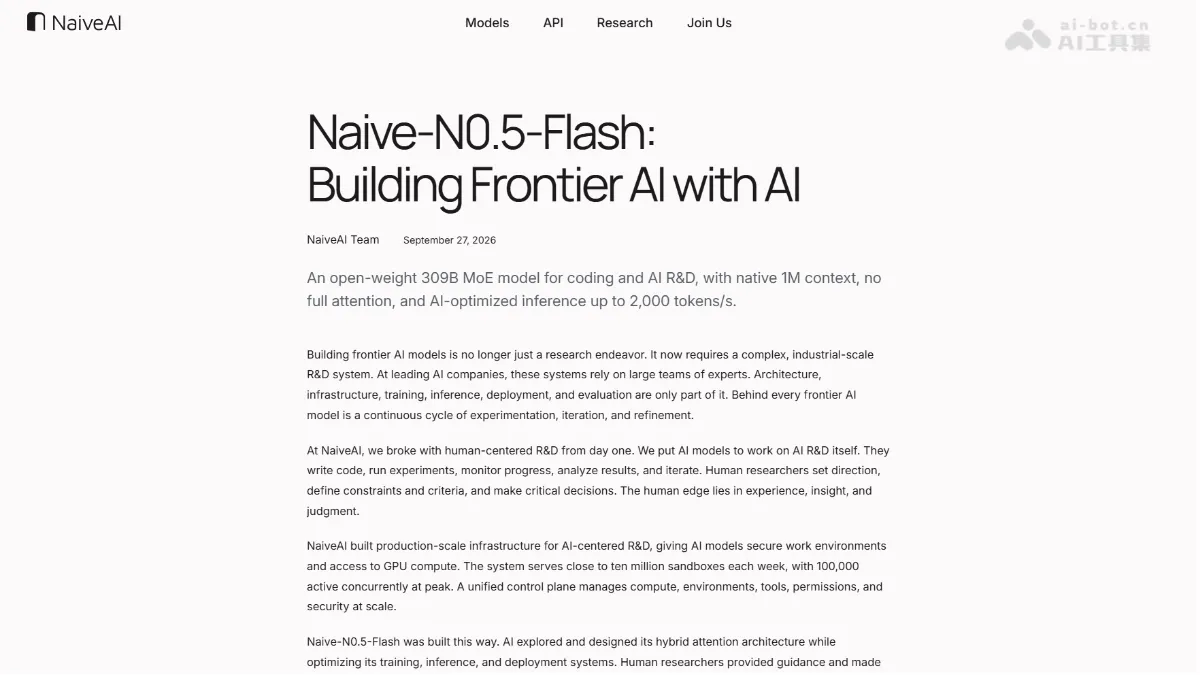
Naive-N0.5-Flash 是 NaiveAI 开源的首个 MoE 大模型,定位编程与 AI 研发场景。Naive-N0.5-Flash 基于小米 MiMo-V2.5 基模改造,为 309B MoE 架构,采用 SWA+DSA 混合稀疏注意力,原生支持 1M 上下文且无全注意力层。模型由 AI 深度参与研发,配套推理系统 NaiveRT 单流解码峰值达 2122 tokens/s。
Naive-N0.5-Flash的主要功能
长上下文编程 :原生支持 1M token 上下文,可处理超长代码仓库与长程软件工程任务。
AI 研发辅助 :能读论文、复现方法、跑实验、分析结果,直接参与模型研发全流程。
推理加速 :配套 NaiveRT 推理系统,标准模式 50 tokens/s,极速模式单流解码峰值达 2,122 tokens/s。
自主科研 :可在给定目标、算力预算和评测协议后,端到端自主推进研究。
Naive-N0.5-Flash的技术原理
SWA–DSA 混合稀疏注意力 :模型基于 MiMo-V2.5 基模,将原本开销大的全局注意力层替换为 DeepSeek 稀疏注意力,与滑动窗口注意力按 5:1 交替堆叠,全网络无任何全注意力层。SWA 处理 128 token 局部窗口,DSA 由轻量索引器对全历史打分并选出 top-2048 token 供主干计算。
轻量索引器设计 :将 DSA 原本的 MLA 改为 GQA,索引器查询头从 64 减至 16,使索引选择路径耗时降低 44%,同时在 1M 上下文的 Agent 任务上保持性能不衰减。
三阶段训练流程 :先在 50B token 上冻结主干、用 KL 散度损失对齐索引器与全注意力分布;再切换稀疏注意力进行 3T token 继续预训练,适配新的信息选择机制并强化编程与研发能力;最后 200B token 监督微调并衰减学习率。全程维持 1M 上下文,AI 自动完成 top-k 召回分析与数值稳定性修复。
混合序列并行与显存优化 :针对 SWA 只需局部窗口、DSA 需全历史的差异,分别采用 Halo 序列并行;显存侧将激活卸载粒度细化到算子级,显式保留 top-k 索引避免重计算改变选择,512 卡约 4 天可训 1T token。
NaiveRT 推理优化 :通过巨型算子融合、PDL 让上下流 kernel 重叠执行、投机解码循环完全在 GPU 上推进,将单轮解码延迟从 12.3ms 降至 3.4ms;且支持按随机种子逐位确定性采样,保证 RL 训练中采样与训练 logprob 一致。所有优化以端到端真实模型路径为准入标准。
如何使用Naive-N0.5-Flash
确认硬件 :需要支持 FP8 的 NVIDIA GPU,模型权重约 315GB,需预留额外显存。
获取权重 :从 Hugging Face 拉取 NaiveAI/Naive-N0.5-Flash-FP8 仓库。
安装依赖 :执行 pip install "transformers[torch,kernels]=5.17.0" 。
加载模型 :用 AutoTokenizer 和 AutoModelForCausalLM 以 trust_remote_code=True 、 device_map="auto" 方式加载。
构造输入 :通过 apply_chat_template 传入对话消息并生成输入张量。
生成结果 :调用 model.generate() 生成回复,再用 tokenizer.decode() 解码输出。
设置参数 :通用场景推荐 temperature=1.0、top_p=0.95。
复现高性能推理 :如需 2,122 tokens/s 速度,可获取 NaiveRT 开源代码、Docker Compose 环境和配套基准脚本自行部署。
Naive-N0.5-Flash的核心优势
超长上下文 :原生支持 1M token 上下文,且全网络无全注意力层,长序列解码开销远低于常规架构。
推理速度顶尖 :配套 NaiveRT 系统单流解码峰值达 2,122 tokens/s,投机解码延迟较 SGLang 降低 72.4%。
研发能力突出 :PaperBench 63.2、MLE-bench-30 73.7%、NanoGPT SpeedRun 73.8s,多项 AI 研发评测超越同级模型。
AI 原生研发 :模型由 AI 参与架构设计与系统优化,是人类设定目标、AI 执行迭代的AI 研发 AI范式落地。
自主科研潜力 :给定目标与预算后可端到端自主完成研究,400 小时训出 AutoWM 世界模型并登顶 WorldArena。
Naive-N0.5-Flash的项目地址
项目官网 :https://naive.ai/en/research/
GitHub仓库 :https://github.com/NaiveAI-Labs/Naive-N0.5-Flash
HuggingFace模型库 :https://huggingface.co/NaiveAI/Naive-N0.5-Flash
Naive-N0.5-Flash的同类竞品对比
对比维度 | Naive-N0.5-Flash | DeepSeek-V4.1-Flash
对比维度 | Naive-N0.5-Flash | DeepSeek-V4.1-Flash |
|---|---|---|
架构 | 309B MoE,SWA+DSA 混合稀疏注意力,无全注意力层 | MoE(具体稀疏架构以官方披露为准) |
总参数 / 激活参数 | 309B / 15.5B | 官方披露(Flash 系列定位轻量激活) |
上下文长度 | 原生 1M tokens | 以官方披露为准 |
推理速度 | NaiveRT 单流峰值 2,122 tokens/s,投机解码 3.4ms/轮 | 常规推理栈,无同等级单流优化数据 |
NL2Repo 得分 | 71.9(高于对方) | 低于 71.9 |
研发定位 | 专为 AI 研发训练,PaperBench 63.2、MLE-bench-30 73.7% | 通用编程模型,研发专项评测数据较少 |
研发模式 | AI 参与架构设计与系统优化(AI4AI / RSI 路线) | 传统人类主导研发 |
Naive-N0.5-Flash的应用场景
AI 研发助手 :辅助研究员读论文、复现方法、跑实验与分析结果,如 PaperBench、MLE-bench 类研发任务。
长程软件工程 :凭借原生 1M 上下文处理大型代码仓库,完成跨文件理解、Bug 修复与仓库级代码生成。
长上下文 Agent 任务 :在终端操作、多轮工具调用等长交互场景中保持完整任务历史。
RL 训练基础设施 :配合 NaiveRT 的高单流解码速度与逐位确定性采样,加速长程强化学习 rollout,减少掉队样本。