Vidu Q4 Preview 生数科技推出的新一代旗舰视频生成模型
Vidu Q4 Preview是什么
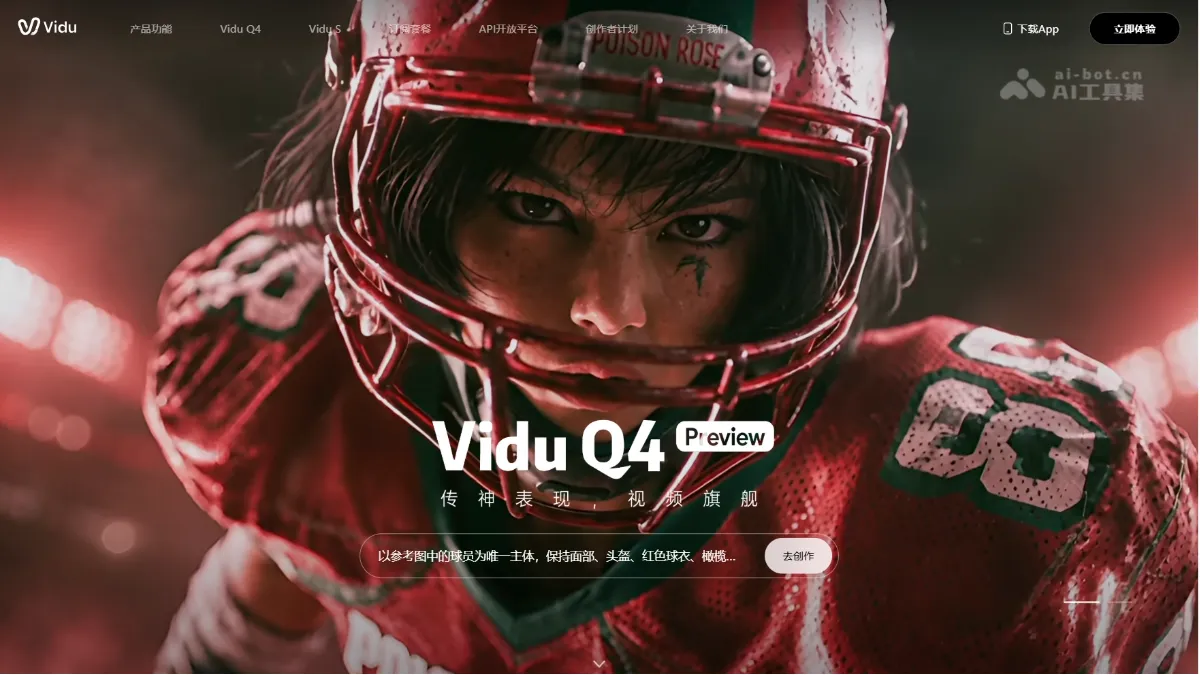
Vidu Q4 Preview 是生数科技推出的全新一代旗舰视频生成模型的首个预览版。Vidu Q4 Preview 在人物演绎上全面升级,表情更细腻、情绪更饱满、动作更自然,支持最多 15 张参考图与 3 段参考音频,让角色形象、场景与音色保持高度一致。镜头语言方面强化动态运镜、丝滑切镜与复杂场景衔接,爆炸、烟火、粒子等视效也更富冲击力,支持 2K/4K、10bit 色深输出。
Vidu Q4 Preview的主要功能
传神人物演绎 :表情更细腻、情绪更饱满、肢体动作更自然,文戏情绪流动与武戏紧张爆发皆具感染力。
声音参考 :最多支持 3 段参考音频,让角色音色统一、台词情绪表达更有张力。
多图参考一致性 :最多支持 15 张参考图,实现人物、场景、道具等多主体视觉一致,支撑复杂创意落地。
镜头叙事 :强化动态运镜、切镜与复杂镜头衔接,打斗、追逐、对峙等场景运镜更有张力。
燃魂视效 :爆炸、烟火、粒子、能量流动等视效随剧情自然发生,支持 2K/4K、10bit 色深输出。
Vidu Q4 Preview的技术原理
U-ViT 扩散 Transformer 架构 : Diffusion Transformer 架构核心思想是将扩散模型与 Transformer 结合:用可扩展的 Transformer 主干取代传统卷积 U-Net,将时间、文本条件与噪声图像 patch 统一视为 token 序列,通过长跳跃连接增强浅层与深层的信息流动,在图像与视频生成任务上取得更优保真度与帧间连贯性。
扩散式生成流程 :生成过程遵循 Latent Diffusion 范式:用 VAE 将视频压缩至低维潜在空间,将空间时间数据 patchify 为 token 序列并附加位置编码,由扩散 Transformer 在Transformer块中基于文本提示词等条件进行迭代去噪,通过全局自注意力捕捉帧内空间与帧间时间的依赖关系,将纯噪声逐步还原为符合语义的潜在表示,由视频解码器还原为原始分辨率画面,支持不同分辨率输出。
多参考条件化机制 :参考生视频(reference2video)能力建立在统一的条件注入之上:1–15 张参考图经视觉编码后与文本提示词一同作为条件 token 输入模型,提示词中可通过标签引用指定参考主体,在生成全程锁定人物、场景、道具的外观与身份一致性;0–3 段参考音频则作为音色条件注入,使声画同源、角色音色统一。
声画联合生成 :Vidu 系列采用音视频联合建模的端到端方案,在同一生成流程中同时产出画面与对白、音效,避免音画分离生成再拼接带来的口型错位与节奏割裂。
如何使用Vidu Q4 Preview
进入官网 :访问 Vidu 官网或RunningHub,注册/登录账号。
选择生成模式 :根据需求选择「参考生视频」或「图生视频」。
上传参考素材 :上传参考图与 MP3 音频,在提示词中用标签引用对应参考主体。
输入提示词 :描述画面内容、运镜方式与情绪氛围,可选开启「智能多帧」增强生成效果。
设置规格参数 :选择分辨率、画幅比例与时长。
点击生成 :消耗积分生成视频,约 10 秒左右出片,可反复试拍调整。
迭代优化 :不满意时调整提示词、参考图或机位描述重新生成,直至效果满意。
导出交付 :确认成片后以 2K/4K 高清规格导出;API 用户可通过 api.vidu.com 的 viduq4-preview 接口集成调用。
Vidu Q4 Preview的核心优势
传神表现力 :表情细腻、情绪饱满、动作自然,文戏武戏皆有感染力,延续 Vidu Q 系列「为剧而生」的传统。
业界最高参考容量 :最多 15 张参考图 + 3 段参考音频,实现人物、场景、道具与音色的多主体一致性。
镜头叙事能力强 :动态运镜、丝滑切镜与复杂镜头衔接自然,对峙、追逐、打斗等场景更有张力。
视效更具冲击力 :爆炸、烟火、粒子、能量流动等复杂视效随剧情自然发生,在动漫与高燃题材上优势鲜明。
旗舰画质规格 :支持 2K/4K 输出与 10bit 色深,光影、质感与细节呈现空间更大。
Vidu Q4 Preview的同类竞品对比
对比维度 | Vidu Q4 Preview | 可灵 3.0(Kling 3.0)
对比维度 | 可灵 3.0(Kling 3.0) | |
|---|---|---|
技术架构 | U-ViT 扩散 Transformer + 统一条件注入 | All-in-One 多模态视觉语言(MVL)架构 |
参考图容量 | 最多 15 张参考图 + 3 段参考音频(公开模型最高) | 元素绑定(Element Binding)系统,参考图与主体合计约 4–7 个 |
最高分辨率 | 2K / 4K,10bit 色深 | 原生 4K / 60fps(Ultra 档) |
单段时长 | 3–16 秒,声画同出 | 3–15 秒,可延展至 3 分钟(专业版) |
原生音频 | 支持,参考音色统一 | 支持,5+ 语言口型同步 |
镜头控制 | 动态运镜、丝滑切镜、复杂衔接(自动) | 6 镜头分镜系统,AI 导演自动/手动编排 |
Vidu Q4 Preview的应用场景
广告与电商营销 :低成本批量生成多版本开场、脚本与镜头方案进行 A/B 测试,筛选最优方案后再以 2K/4K 输出成片,突出产品材质、光影与视觉冲击力,大幅压缩营销视频的制作成本与周期。
漫剧 / 短剧 / 影视内容生产 :用 15 张参考图 + 3 段音频实现角色形象与音色跨集一致,16 秒声画同出适合连载更新,传神演技与张力镜头让文戏情绪、武戏爆发都更具感染力。
分镜预演与创意验证 :将剧本快速转化为可视化动态分镜,验证人物调度、镜头路径、场面设计与情绪节奏,先让想法被看见,再决定哪些镜头值得投入更多制作资源。
动漫与高燃题材创作 :动态运镜、丝滑切镜与爆炸、烟火、粒子等燃魂视效,契合热血动漫、动作短片的叙事节奏,是 Vidu 传统优势主场。