Mellum2.1 JetBrains 开源的 AI 编程模型
Mellum2.1是什么
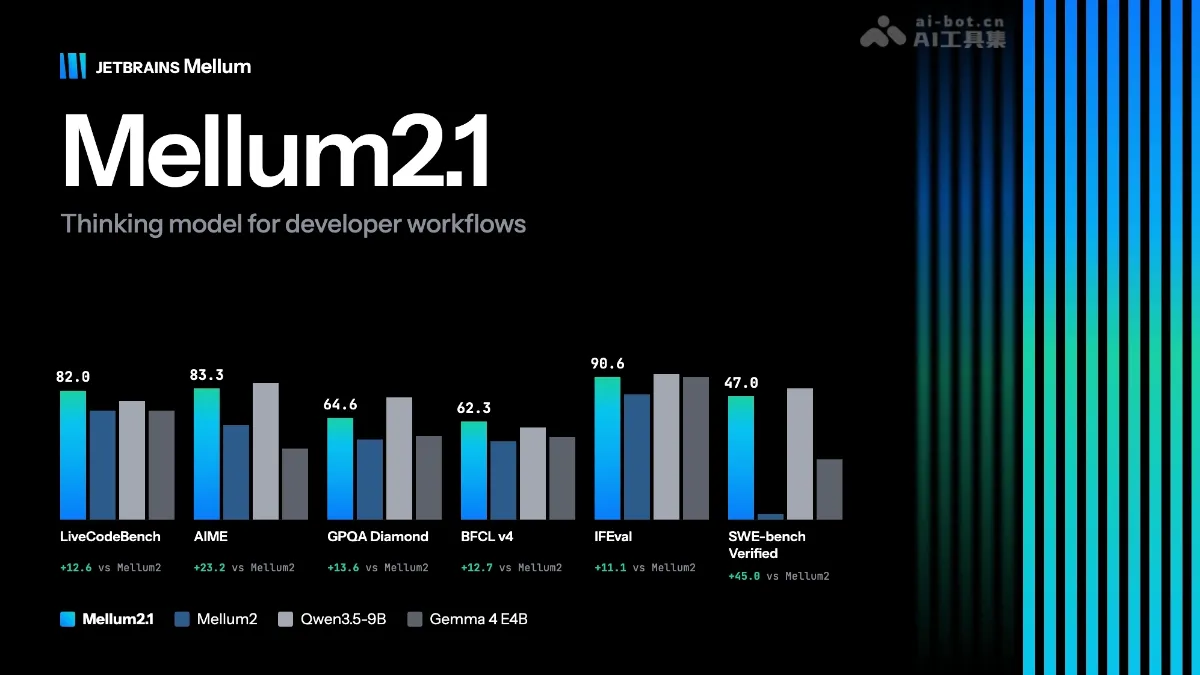
Mellum2.1 是 JetBrains 推出的开源 AI 编程模型,采用 12B 混合专家架构。Mellum2.1强化学习从收尾环节变为训练主体,结合数百万次沙盒运行,模型能探索代码库、编辑文件、自查修改,智能体编程能力大幅提升。Mellum2.1高负载吞吐接近 Qwen3.5-9B 两倍,支持私有化部署,已上架 Hugging Face。
Mellum2.1的主要功能
智能体编程 :探索代码库、编辑文件并自查修改,可定位失败测试根因、起草并验证修复方案。
代码补全与生成 :延续 Mellum2 的定位,为编码工作流提供快速代码生成与问答能力。
工具调用 :能调度外部工具完成任务,适用于构建 AI 智能体系统。
通用推理 :可处理日常问答,并能逐步推导演算数学和逻辑难题。
私有化部署 :支持本地或自有基础设施运行,代码与数据完全保留在企业内部。
Mellum2.1的技术原理
混合专家(MoE)架构 :Mellum2.1 采用 12B 参数的混合专家架构,每次推理仅激活 2.5B 参数。模型由多个专家子网络组成,输入经路由机制只分发给部分专家处理,从而在保证模型容量的同时大幅降低计算量,实现小开销、高吞吐的推理。
大规模强化学习(RL) :本版的核心升级在于训练流程:RL 从预训练后的短暂收尾环节扩展为训练主体。团队新增数学、竞赛编程、科学、工具使用和软件工程等任务,自建基础设施在训练期间启动数百万个沙盒、覆盖数千个真实环境,让模型在与真实编码场景的交互中通过试错和奖励信号习得智能体所需的探索、编辑与验证能力。
数据严格筛选 :训练所用的开放数据集在入库前全部经过过滤,剔除存在测试缺陷、答案不可验证或难度失当的任务,确保 RL 训练信号可靠,避免模型从错误反馈中学习。
多 Token 预测(MTP) :MTP 让模型在单次前向传播中预测多个后续 Token。单请求场景下速度提升约 1.6 倍,配合 MoE 的低激活参数设计,使 Mellum2.1 在高负载下的吞吐接近 Qwen3.5-9B 的两倍。
如何使用Mellum2.1
访问模型页面 :打开 Hugging Face 上的 JetBrains 官方组织页面,找到 Mellum2.1 模型仓库。
下载模型权重 :在模型卡页点击下载或按许可条款拉取模型文件(如有门槛需先同意使用协议)。
选择部署框架 :使用 Transformers 或 vLLM 进行部署,前者适合简单验证,后者适合生产级高并发服务。
配置推理环境 :准备好 GPU 环境(官方基准基于单张 H200),加载模型并设定 131K 上下文参数。
启用加速选项 :按官方指引配置多 Token 预测(MTP)以提升单请求速度约 1.6 倍。
发起推理调用 :通过 API 发送代码生成、仓库级编辑或智能体任务提示词,获取模型输出。
Mellum2.1的核心优势
智能体编程能力突出 :经真实环境大规模 RL 训练,能自主探索代码库、编辑文件并验证修改,可定位测试失败根因并起草修复方案。
推理速度行业领先 :高负载下吞吐接近 Qwen3.5-9B 的两倍,是同级模型中最快的。
单请求响应快 :多 Token 预测(MTP)技术使单请求速度提升约 1.6 倍。
架构高效 :12B MoE 设计仅激活 2.5B 参数,以低算力成本实现高性能。
训练数据质量高 :所有训练数据经严格筛选,剔除缺陷任务,确保学习信号可靠。
综合能力强 :在编程、竞赛编程、数学、工具调用和通用知识等维度全面提升。
私有化部署友好 :支持本地或自有基础设施运行,代码与数据完全自主可控,适合企业敏感场景。
Mellum2.1的项目地址
项目官网 :https://blog.jetbrains.com/ai/2026/10/mellum2-1-gets-to-work-a-fast-open-model-for-coding-agents/
HuggingFace模型库 :https://huggingface.co/JetBrains/Mellum2.1-12B-A2.5B-Thinking
Mellum2.1的同类竞品对比
对比维度 | Mellum2.1(JetBrains) | Qwen3.5-9B(阿里)
对比维度 | Mellum2.1(JetBrains) | Qwen3.5-9B(阿里) |
|---|---|---|
模型架构 | 12B 混合专家(MoE),激活 2.5B | 9B 稠密架构 |
核心定位 | 编码智能体 / 子智能体、私有化部署 | 通用大模型,兼顾代码能力 |
智能体编程 | 强项:可探索代码库、编辑文件、自查修改、定位测试失败根因 | 具备工具调用能力,但官方未主打仓库级智能体操作 |
训练方式 | 强化学习为训练主体,数百万次真实沙盒环境运行 | 常规预训练 + 后训练(未公开同规模 RL 沙盒训练) |
推理速度 | 高负载吞吐接近 Qwen3.5-9B 两倍,单请求靠 MTP 提速约 1.6 倍 | 基准参照物,吞吐相对较低 |
多 Token 预测 | 内置 MTP,且 vLLM 推测解码头即将推出 | 未公开同等 MTP 能力 |
综合性能 | 编程、数学、竞赛、工具调用、通用知识全面提升 | 通用能力强,各项为 Mellum2.1 的对比基准 |
生态背景 | 阿里通义生态,Qwen 系列社区庞大 |
Mellum2.1的应用场景
智能体编程 :自主探索代码库、编辑文件并验证修改,完成从定位测试失败到修复的全流程。
企业私有化助手 :本地部署在企业服务器,保障代码与数据不出内网。
IDE 深度集成 :嵌入 JetBrains 系列 IDE 或第三方工具,提供代码补全与智能问答。
子智能体调度 :依托低延迟高吞吐特性,在多智能体系统中执行子任务或路由请求。
数学逻辑推理 :处理数学解题、算法竞赛及日常问答,兼具通用助手能力。