Xiaomi-CocktailASR-1 小米开源的说话人语音识别模型
Xiaomi-CocktailASR-1是什么
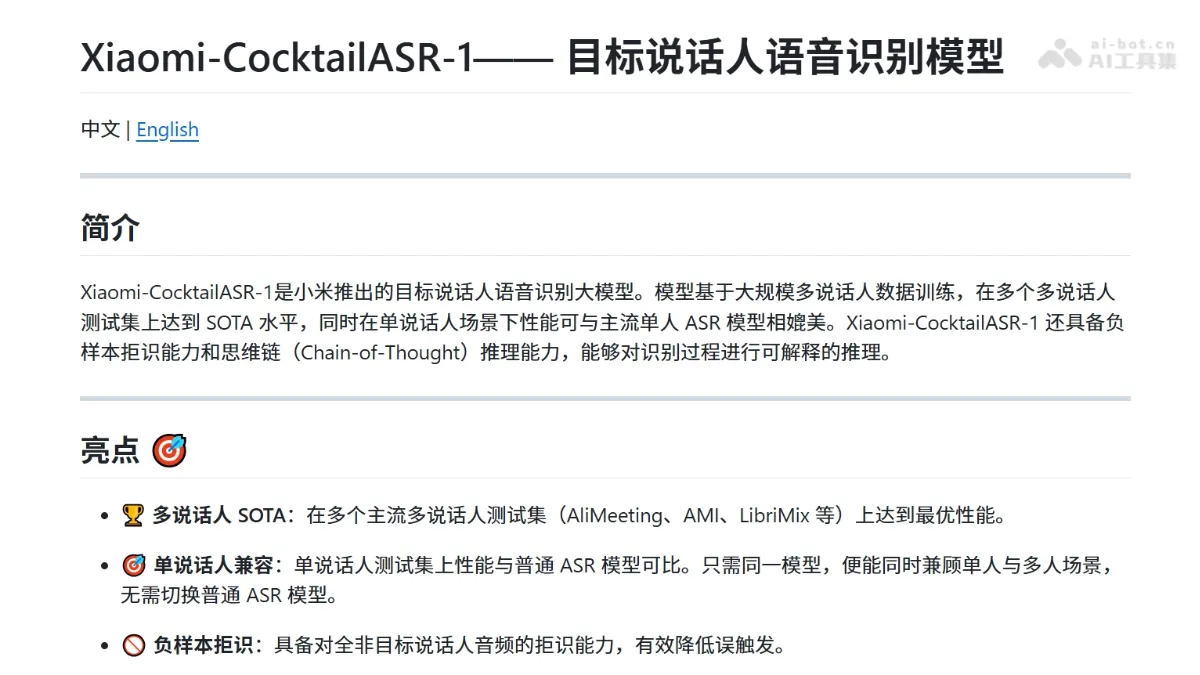
Xiaomi-CocktailASR-1是小米开源的目标说话人语音识别大模型,基于LLM端到端架构,用参考语音作为声纹提示,无需语音分离可从多人混合语音中精准转录目标说话人。模型在多说话人基准上达SOTA水平,同时兼容单说话人场景,具备负样本拒识与思维链可解释推理能力,采用Apache 2.0协议开源。
Xiaomi-CocktailASR-1的主要功能
- 目标说话人语音识别 :给定参考语音与多人混合音频,直接转录目标说话人的内容,无需语音分离。
- 单说话人兼容 :同一模型即可处理单人场景,性能媲美主流单说话人 ASR,无需切换模型。
- 负样本拒识 :目标说话人不在音频中时输出空文本,有效降低误触发。
- 思维链推理 :CoT 模式输出说话人数、性别、声纹相似度等推理过程,兼顾可解释性与识别精度。
Xiaomi-CocktailASR-1的技术原理
- 端到端统一架构 :模型由三部分组成:基于 Data2Vec2 改进的 0.6B 音频编码器、轻量级线性 Adapter,及 Qwen3-8B 大语言模型骨干。输入按「参考语音 + 1 秒静音 + 混合语音」的顺序拼接,编码器输出帧级特征后,经 Adapter 对齐到 LLM 隐空间,与文本 Prompt 共同送入 LLM 生成目标说话人的转录。
- 参考语音作为条件提示 :编码器用 Data2Vec2 自监督掩码预测机制,在单一网络内融合语义与说话人信息,无需独立声纹编码器;参考语音被视作条件 Prompt,使编码器在特征提取阶段即自适应聚焦目标说话人、抑制干扰语音,从源头避免传统「分离+识别」级联系统的误差累积。
- 多能力平衡的多阶段训练 :通过约百万小时数据配比训练统一四种能力:约 40 万小时多说话人数据训练目标提取,约 60 万小时同说话人参考-目标对防止单场景过度抑制,约 1 万小时错配参考的负样本内化拒识能力且推理无需阈值,另有 CoT 数据教会模型先输出推理链再给出答案。
- 双模式 Prompt 与拒识机制 :标准模式用统一 Prompt 同时覆盖单人识别、多人目标识别与负样本拒识三类任务,目标缺失时模型自然输出空文本;CoT 模式则以独立 Prompt 触发 think 推理标签,输出说话人数量、性别与声纹相似度等中间步骤后再给出 answer 最终转录,提升可解释性并小幅降低 WER。
如何使用Xiaomi-CocktailASR-1
- 安装依赖 :执行 pip install torch torchaudio transformers soundfile 安装所需环境。
- 下载模型 :从 HuggingFace( Ease3/Xiaomi-CocktailASR-1 )下载模型权重文件。
- 加载模型 :通过 AutoModel.from_pretrained("Ease3/Xiaomi-CocktailASR-1", trust_remote_code=True, torch_dtype="bfloat16").cuda().eval() 加载模型。
- 准备音频 :准备一段 16k 单声道参考语音(目标说话人声纹)和一段待识别的单人/多人音频(非 16k 会自动重采样)。
- 单条推理 :调用 model("target.wav", "ref_speaker.wav") 即可返回目标说话人的转录文本(负样本时自动输出空文本,无需额外参数)。
- 思维链推理 :追加 cot=True 参数,模型会在 think 中输出推理过程、在 answer 中输出最终结果。
- 批量推理 :将数据整理为 5 列 TSV( utt_id, wav, text, ref_wav, ref_id ),运行 tools/test_batch_scp.py 并指定模型路径、输入 TSV 和输出文件即可批量转录。
Xiaomi-CocktailASR-1的核心优势
- 多说话人 SOTA 性能 :在 AliMeeting、AMI、LibriMix 等多个主流多说话人基准上达到最优识别水平(如 AliMeeting Far WER 20.63%,此前 SOTA 为 27.5%)。
- 单多人场景统一 :同一模型在单说话人场景下性能媲美主流 ASR,无需按说话人数切换模型。
- 负样本拒识能力 :目标说话人缺席时输出空文本,拒识率达 68%-80%,而 Qwen3-ASR、StepAudio 等模型拒识率为 0。
- 思维链可解释推理 :CoT 模式输出说话人数、性别、声纹相似度等推理过程,既提升可解释性又能小幅降低 WER。
- 端到端简洁架构 :参考语音直接作为声纹 Prompt,免去传统语音分离模块,避免级联系统的误差累积。
- 使用门槛低 :一行代码调用、支持自动重采样与批量推理、提供正负样本 Demo,开箱即用。
Xiaomi-CocktailASR-1的项目地址
- GitHub仓库 :https://github.com/xiaomi-research/xiaomi-cocktailasr-1
- HuggingFace模型库 :https://huggingface.co/Ease3/Xiaomi-CocktailASR-1
- arXiv技术论文 :https://arxiv.org/pdf/2609.11274
Xiaomi-CocktailASR-1的同类竞品对比
对比维度 | Xiaomi-CocktailASR-1 | Qwen3-ASR
| 对比维度 | Xiaomi-CocktailASR-1 | Qwen3-ASR |
|---|---|---|
| 产品定位 | 目标说话人语音识别(TS-ASR),专攻多人混合场景 | 通用语音识别大模型(LALM),覆盖多语言与方言 |
| 多说话人识别 | 🏆 SOTA:LibriMix 2mix WER 4.11%,AliMeeting Far 20.63% | 基本失效:LibriMix 2mix WER 68.75%,AliMeeting Far 39.64% |
| 单说话人识别 | 强劲:LibriSpeech WER 1.73%,CommonVoice(zh) 4.95% | 相当:LibriSpeech WER 1.87%,CommonVoice(zh) 5.39% |
| 负样本拒识 | ✅ 拒识率 68%-80%(LibriSpeech neg 79.59%) | ❌ 拒识率 0%,目标缺席时仍会误转录 |
| 可解释推理 | ✅ 支持 CoT 思维链,输出声纹相似度等推理过程 | ❌ 不支持 |
| 技术架构 | Data2Vec2 编码器 + Adapter + Qwen3-8B,参考语音作 Prompt 免语音分离 | 通用音频编码 + LLM 端到端架构 |
| 使用方式 | model(target, ref) 一行调用,需目标说话人参考音频 |
常规 ASR 调用,无需参考音频 |
Xiaomi-CocktailASR-1的应用场景
智能会议定向转写 :在多人会议中只听转指定发言人的内容,自动过滤其他与会者的插话与讨论。
相关工具
与本文相关的 AI 工具