WeVisOne-VL 微信视觉团队开源的视觉-语言基础模型
WeVisOne-VL是什么
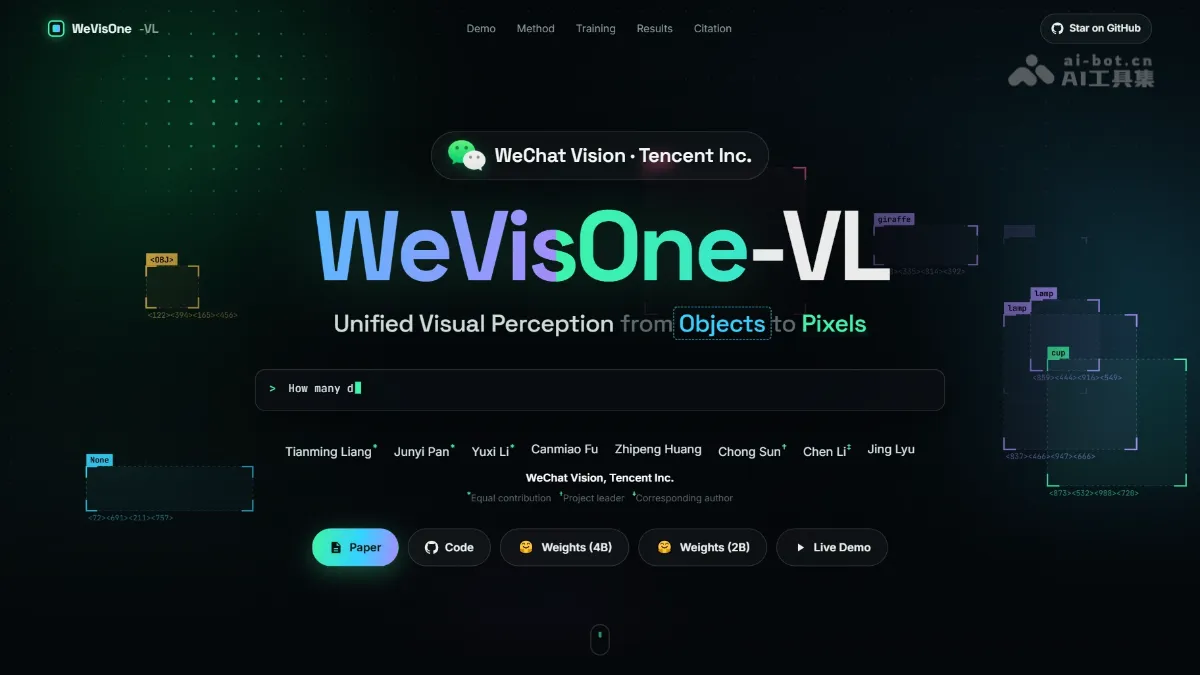
WeVisOne-VL 是腾讯微信视觉团队开源的视觉-语言基础模型,基于 Qwen3-VL,提供 2B 和 4B 两个版本。WeVisOne-VL 用统一的结构化 token 预测方式,让一个模型同时完成检测、指代定位、计数、指点、OCR、指代分割和可提示抠图七类任务,通过一个仅 960 万参数的像素解码器直接输出掩码或发丝级抠图,无需外挂 SAM。WeVisOne-VL 训练数据超 1 亿张图、约 36 亿个目标框,经三阶段课程式微调加强化学习,在 30 余个基准上领先同类模型。
WeVisOne-VL的主要功能
- 目标检测 :可以根据找出所有狗类指令直接输出图中全部目标框。
- 指代定位 :可以根据穿红衣服的人等自然语言描述锁定图中具体目标。
- 计数 :回答图中有多少个指定类别的物体。
- 指点 :理解那个杯子等指向性描述,找到被指的物体。
- OCR :读取图中文字内容并标注其位置。
- 指代分割 :沿目标轮廓逐像素描边,输出二值掩码。
- 可提示抠图 :输出连续 alpha 通道,发丝等半透明细节保留自然,可直接换背景。
WeVisOne-VL的技术原理
- 坐标即 token 的结构化输出 :模型把坐标离散化为 1001 个专用 token,一个框恰好占 4 个 token、一个点占 2 个 token,检测框、文字位置和像素掩码都用同一套词表表达,再用结构化 next-token 预测统一生成,换任务只是换 prompt 前缀,目标不存在时直接输出 None。
- 内嵌像素解码器替代 SAM 级联 :模型在 Qwen3-VL 底座外接一个仅 960 万参数的小模块,视觉特征适配器先取底座预合并前的四层 ViT 特征经深度卷积细化成共享特征金字塔,每个 OBJ token 的隐状态加上傅里叶编码的框先验组成实例查询,经 6 个可变形交叉注意力块迭代细化,最后由实例条件稠密头先用动态卷积核预测掩码、再经 S/4→S/2→S/1 粗到细级联恢复发丝级全分辨率 alpha 抠图,全程不依赖 SAM 等外部分割模型。
- 课程式训练加混合任务强化学习 :预训练后依次经历任务对齐、高分辨率与密集场景、像素级三阶段 SFT,最后用 178K 不确定性筛选的样本做混合任务 GRPO 强化学习,框更准、幻觉更少,其中图里没有目标也要框和图里有目标却漏框两类错题被重点惩罚,使拒识能力与有目标时的定位精度同步提升。
- 知识图谱驱动的数据引擎 :以类别和指代表达的知识图谱做目标化采集,由 SAM3 加内部 DINO 检测器产候选框、Qwen3-VL 交叉验证真伪、SAM2 扩展成掩码、BiRefNet 与 MatAnyone2 生成连续 alpha 候选,样本须通过 IoU、覆盖率、前景精度等一系列检查才被接受,部分人工抽查,模型犯的错误回流进下一轮筛选,累计标注超 1 亿张图、约 36 亿个目标框,形成自我改进的标注闭环。
如何使用WeVisOne-VL
- 获取代码 :从 GitHub 克隆 Tencent/WeVisOne-VL 仓库并按 README 安装依赖环境。
- 准备模型 :从 Hugging Face 下载 WeVisOne-VL-2B 或 WeVisOne-VL-4B 权重。
- 构造任务提示 :按任务在 prompt 中写明需求,如检测Locate all the instances of …、指代定位描述目标、抠图要求输出 alpha,并可通过 ref 、 box 、 point 等结构化标签传入已有标注。
- 调用推理 :用仓库提供的 model.predict() 接口(官网演示即此接口)把图片加提示送入模型。
- 解析输出 :模型逐 token 生成结果,坐标从 0 – 1000 专用 token 还原为归一化坐标, OBJ 触发像素解码器输出掩码或 alpha,目标不存在则返回 None。
- 后处理应用 :把框、掩码或抠图结果映射回原图尺寸,可用于检索、标注、换背景等下游任务。
WeVisOne-VL的核心优势
- 拒识可靠 :图里没有目标时敢说没有,不再硬凑答案,大幅降低视觉感知环节的幻觉。
- 一模型多任务 :检测、指代定位、计数、指点、OCR、分割、抠图七类任务共用同一模型,换任务只需换提示词,省去多模型拼接的部署和维护成本。
- 免外挂 SAM :内置 960 万参数像素解码器直接输出掩码和发丝级抠图,替代检测器+SAM+抠图模型的三段级联,推理链更短。
- 精度和细分粒度兼得 :1 亿张图、36 亿框的大规模标注加课程式训练与混合任务强化学习,使其在 30 余个基准上同时领先通用 VLM 和专用模型,抠图 MAD 几乎减半。
- 开源可部署 :2B 和 4B 两个版本权重、代码和工具链全量开放,Apache 2.0 许可,可网页试用也可本地运行,对小团队友好。
WeVisOne-VL的项目地址
- 项目官网 :https://tencent.github.io/WeVisOne-VL/
- GitHub仓库 :https://github.com/Tencent/WeVisOne-VL
- HuggingFace模型库 :https://huggingface.co/collections/tencent/wevisone-vl
- arXiv技术论文 :https://arxiv.org/pdf/2610.31329
WeVisOne-VL的同类竞品对比
维度 | WeVisOne-VL-4B | Qwen3-VL-8B
| 维度 | WeVisOne-VL-4B | Qwen3-VL-8B |
|---|---|---|
| 参数量 | 4B | 8B(约为前者 2 倍) |
| 任务覆盖 | 检测、指代定位、计数、指点、OCR、分割、抠图七合一 | 通用图文理解,grounding/检测可用但无原生抠图 |
| 像素级输出 | 内置 9.6M 解码器直出掩码与发丝级 alpha | 需外接 SAM 等分割模型 |
| 拒识能力(WeRef-Bench) | 96.4% | 18.3% |
| 有目标定位质量(WeRef cIoU / F1) | 78.7(F1) | 74.9 / 22.5 |
| 检测(LVIS) | 55.3 | 50.7(最强基线水平) |
| 计数(PixMo-Count) | 89.6 | 82.8 |
| OCR(TotalText) | 52.0 | 43.3 |
| 部署形态 | 免外挂分割模型,单模型部署 | 完整像素级流程需多模型拼接 |
WeVisOne-VL的应用场景
- 内容审核与安全检测 :凭敢说没有的拒识能力精确找出图中违规物体,找不到即明确返回无,减少漏审误报,契合微信内容生态的审核需求。
- 电商商品抠图 :输入商品图直接输出发丝级 alpha 抠图,一键生成白底图和换背景海报,替代人工修图和多模型拼接流水线。
- 文档票据结构化 :OCR 加位置输出把发票、合同、表单转成带坐标的结构化数据,实现自动化录单与对账。
- 数据标注与检索增强 :用指代定位和分割批量产出带框带掩码的标注数据,或以文搜图时返回精确目标区域而非整图,服务下游模型训练与检索。
- 机器人与自动驾驶感知 :端侧部署做环境感知与目标操作,拒识机制避免把空气当障碍物的幻觉,提升作业安全性。
相关工具
与本文相关的 AI 工具