WeVisCut 腾讯微信视觉开源的长视频自动剪辑 Agent
WeVisCut是什么
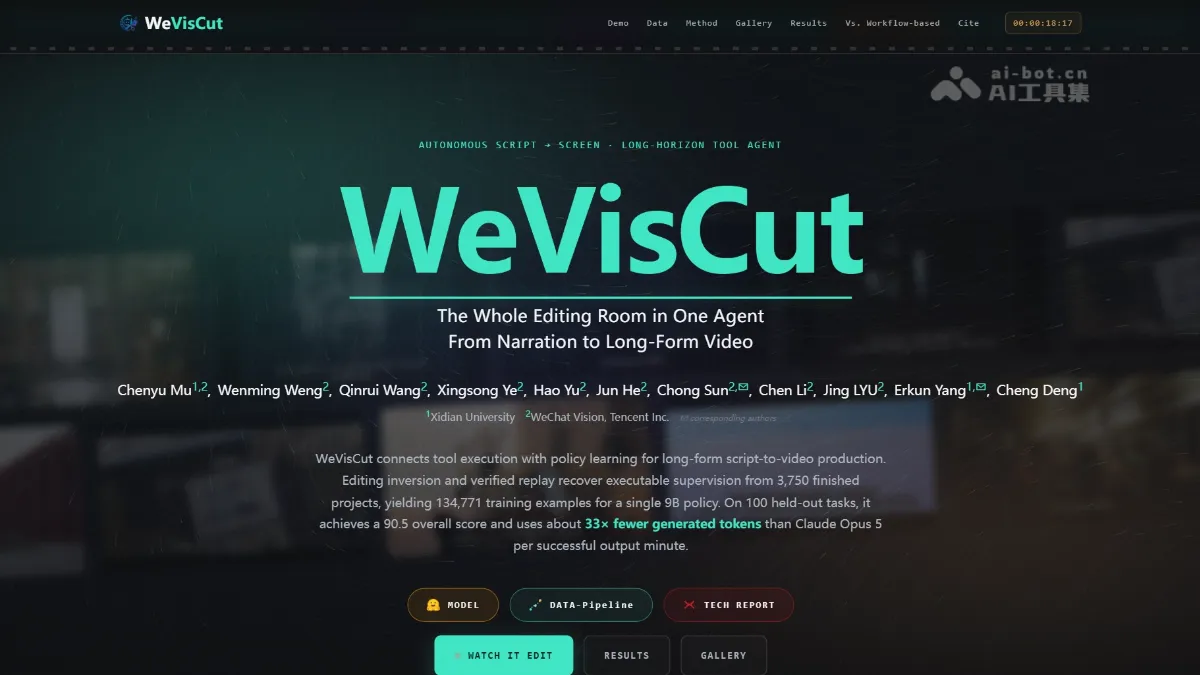
WeVisCut 是腾讯微信视觉开源的长视频自动剪辑 Agent,输入旁白脚本,一个 9B 小模型策略借助共享生产状态的运行时,自动完成分镜、配音、素材检索、合成与质检修复,直接输出数分钟成片。WeVisCut 用编辑反演+验证回放管线从 3,750 条成片恢复出 13 万余条训练数据。评测中与 Claude Opus 5 表现相当,生成 token 节省约 33 倍,每分钟成片成本仅 $0.09。
WeVisCut的主要功能
脚本转长视频 :输入旁白/知识类脚本,自动输出数分钟完整成片,无需人工分镜。
单一策略全链路决策 :一个 9B 模型分饰编排者、生成者、批评者三种角色,替代多阶段 Agent 工作流。 共享生产状态 :harness 持久保存镜头、素材、时间线等状态,前一步工具结果直接约束后一步决策。 闭环质检修复 :策略自动检查成片、定位失败并做有界局部修复,保留已成功的部分不重做。 导演对话式改片 :首轮成片后可通过聊天换素材、改音乐、调字幕,策略局部重规划重交付。 可编辑时间线交付 :Studio 运行时提供 8 轨时间线,支持逐镜重渲染与版本回滚。 低成本私有化 :每成功输出分钟仅约 $0.09、2.1 分钟墙钟时间,9B 权重开源可本地部署。
WeVisCut的技术原理
- 问题定义 :长链路制作的状态管理,长视频脚本转片的难点在于素材选择、工具执行和修复决策相互依赖,每个镜头局部正确不等于全片有节奏。若拆成多个通用 Agent 阶段,每阶段都要重新序列化全局上下文,导致 token 与调用成本随镜头数线性累积。WeVisCut 的核心思路是用一个 9B 策略维持整条制作状态,把理解全局从每步重复做变成一次持续做。
- 状态化 Harness :共享生产状态,Runtime 维护一份持久化的 production state,仅将验证通过的工具结果写入状态。策略每次只发一个工具调用,从当前状态中选择合法动作;非法调用被类型化 blocker 拒绝,强制先补齐依赖再重试。状态与模型上下文分离,策略无需重复携带全量历史。
- 单一策略三角色 :一个共享参数的策略通过角色路由充当编排者、生成者、批评者。动作空间固定为 12 个工具,无硬编码阶段机,整条轨迹由策略自主决定,护栏只拦截非法调用。
- 训练数据 :Editing Inversion + Verified Replay,成片只呈现结果、不暴露编辑意图,作者用四阶段管线恢复监督:先从成片反推脚本—镜头意图,再在 runtime 中重放验证可执行性,回放暴露缺陷时做有界修复并保留成功产物,最后把执行记录物化为带工具反馈的训练例。3,750 条成片转化为 134,771 条可执行监督数据,是让模型学会失败后恢复。
- 三阶段训练 :统一 SFT 加 runtime 验证的 RFT 完成工具使用与恢复行为的初始化;Guided-OPD 引入教师干预训练恢复决策,干预随训练逐步退火;RCF-DAPO 在同一角色、同一生产上下文内比较候选输出以优化决策质量。三阶段将 Overall 从基座的 74.5 提升至 90.5。
如何使用WeVisCut
获取代码 :从 GitHub 克隆仓库 github.com/Tencent/WeVisCut 。
准备环境 :按仓库说明安装 Studio 运行时及依赖。 下载模型 :从 HuggingFace 拉取 tencent/WeVisCut 的 9B 权重。 启动服务 :运行启动脚本加载策略与工具注册表,打开 Studio 网页界面。 输入脚本 :在界面粘贴或上传旁白/知识类长文脚本。 观察制作 :Agent 自动分章、分镜、配音、检索素材并实时构建时间线,过程可视。 对话修改 :首轮成片后通过导演聊天窗口提出修改,局部重交付。 导出成片 :在时间线界面逐镜确认后导出最终视频,或按需回滚版本重新渲染。
WeVisCut的核心优势
- 成本极低 :每成功输出一分钟视频仅需 2,377 个生成 token、$0.09,9B 小模型可私有化部署。
- 交付可靠 :五指标 Overall 90.5 超过基座 16 分,计划实现率、长程一致性、渲染产出率全面领先。
- 一个策略管全程 :单一 9B 模型分饰编排/生成/批评三角色,替代多阶段 Agent 工作流,避免上下文反复重建。
- 状态持续管理 :共享生产状态让前一步工具结果直接约束后一步决策,长链路不丢节奏、不重复理解全局。
- 会自我修复 :训练数据包含失败恢复轨迹,策略能质检、定位问题并做有界局部修复,保留已成功的部分。
- 交互式改片 :成片后可用自然语言对话修改,局部重规划不重拍。
WeVisCut的项目地址
- 项目官网 :https://tencent.github.io/WeVisCut/
- GitHub仓库 :https://github.com/Tencent/WeVisCut
- HuggingFace模型库 :https://huggingface.co/tencent/WeVisCut
- arXiv技术论文 :https://arxiv.org/pdf/2610.38352
WeVisCut的同类竞品对比
维度 | WeVisCut(腾讯微信视觉) | Crayotter
| 维度 | WeVisCut(腾讯微信视觉) | Crayotter |
|---|---|---|
| 系统形态 | 单一 9B 策略 + 共享状态运行时 | 任务匹配的原生工作流系统 |
| 决策方式 | 一个策略分饰编排/生成/批评三角色,无硬编码阶段机 | 预定义编辑流水线 |
| 训练方式 | 从 3,750 条成片反演监督(editing inversion + verified replay),13 万余例 | 环境内最终成片偏好训练 |
| 修复能力 | 闭环质检 + 有界局部修复,保留成功部分 | 无等价的显式恢复学习机制 |
| Overall 得分(100 任务) | 90.5 | 84.9 |
| 脚本保真 SCF | 88.4 | 81.6 |
| 墙钟速度 | 2.1 分钟/输出分钟(快 4.1 倍) | 8.6 分钟/输出分钟 |
| 成本 | $0.09/输出分钟(低 10.8 倍) | $0.97/输出分钟 |
| 人工盲评 Overall | 4.56(六维全领先) | 3.48 |
| 交互改片 | 导演对话式局部重规划 | 未提供同等级交互 |
| 开放性 | 权重+运行时+数据管线全开源(Apache-2.0) | 生态封闭 |
| 短板 | 限于固定 12 工具注册表与模板库风格 | 成本高、速度慢的通用工作流 |
WeVisCut的应用场景
知识科普视频批量生产 :将科普长文/旁白脚本自动转为数分钟讲解视频,适合 MCN 与自媒体日更。