OmniEdu 北大联合国科大等开源的教育多模态模型系列
OmniEdu是什么
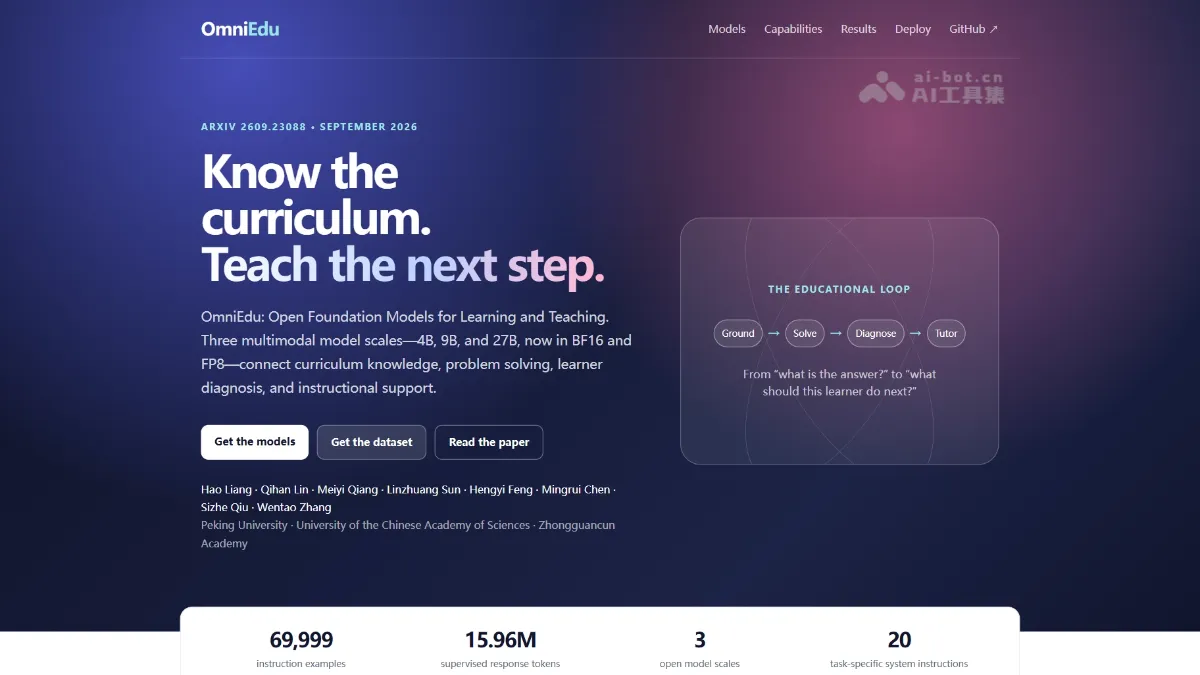
OmniEdu是北京大学DCAI团队联合国科大、中关村学院开源的教育多模态模型系列,提供27B、9B、4B三种规模。OmniEdu强调教学能力,能解答学科题目、判断知识点的课程位置、诊断学生错因,并选择合适的教学动作。团队从134万条候选数据中精选约6.9万条样本进行训练,使模型在多学科、诊断与辅导任务上达到SOTA水平,其中4B小模型可部署于普通服务器,降低学校使用门槛。
OmniEdu的主要功能
- 学科解题 :覆盖数学、科学、阅读理解和写作,给出正确答案并让解释与题目条件、推理过程保持一致。
- 课程理解 :识别题目对应的知识点、年级、难度和前置关系,判断继续学习前需要补充什么。
- 诊断推理 :基于学生的作答过程和错误答案,定位出错步骤、分析理解偏差及需要补充的知识,而非仅凭题目猜测。
- 教学行动 :根据任务选择合适回应方式,包括提示、引导式提问、复习前置概念、指出错误或完整讲解。
OmniEdu的技术原理
- 任务目标驱动的数据设计 :训练数据从约134万条候选样本中经过清理、语义审核、质量评估和多样性筛选保留约6.9万条。每条教育样本按四类能力分类,并分配20种任务指令之一,将样本教什么和模型该怎么回应分开标注,使模型能按任务切换行为。
- 语义审核与改写 :用语言模型按任务标准审核样本,检查解题正确性、课程关系、诊断依据和支架质量,不合格改写监督回答后重审,同时核对多模态样本图文一致性,并保留来源许可信息、排除不合规来源。
- 去污染与结构统一 :统一消息格式,删除重复、缺字段、结构损坏的样本,核对可验证任务的答案,将训练数据与评测集做去重处理,避免结果失真。
- 按 token 预算平衡训练配比 :长辅导对话比短答案含更多监督 token,若按样本条数采样会让长对话占比过大。按任务桶分配 token 预算,并提高关键维度门槛做多样性选择,控制各类教学任务实际获得的监督量。
如何使用OmniEdu
- 方式一:本地运行(Transformers) 安装依赖 :执行 pip install -U torch torchvision transformers accelerate safetensors pillow (FP8 权重需额外装 compressed-tensors )。
- 加载模型 :用 AutoProcessor 和 Qwen3_5ForConditionalGeneration.from_pretrained 加载对应模型 ID(如 lhpku20010120/Omni-Edu-4B ,9B/27B 换 ID 即可)。
- 构造输入 :将学生题目、作答或图片按 chat 模板组织成 messages,图片题目加入 {"type": "image"} 项。
- 生成回答 :调用 generate (务必 enable_thinking=False ),用 batch_decode 解码输出结果。
方式二:部署服务(vLLM,推荐)
- 启动服务 :执行 vllm serve lhpku20010120/Omni-Edu-4B --max-model-len 32768 --reasoning-parser qwen3 --default-chat-template-kwargs '{"enable_thinking": false}' (FP8 版本改用 Omni-Edu-4B-FP8 ,多卡时调 --tensor-parallel-size )。
- 发送请求 :通过 curl 访问 http://localhost:8000/v1/chat/completions ,以 OpenAI 兼容格式提问即可。
方式三:使用官方工具包
- 安装 SDK :执行 pip install omniedu (评测需装 omniedu[eval] )。
- 调用对话 : OmniEdu.from_pretrained("4B", base_url=服务地址) 后使用 model.chat(text=...) 提问。
- 评测对比 :用 omniedu eval --list 查看 12 个教育评测基准并生成报告。
OmniEdu的核心优势
- 任务指令驱动行为切换 :20 种系统指令让同一模型能按任务区分逐步解题、错误诊断、苏格拉底式提问和辅导对话等回应方式。
- 精心设计的高质量训练数据 :从约 134 万候选样本经语义审核、去污染、token 配比平衡后精选约 7 万条,明确学什么与怎么教。
- SOTA 级性能 :27B 在与 GPT-5.4、Claude-Opus-5 等 5 个前沿模型的 60 次比较中胜出 51 次,多项教育指标第一。
- 支架式教学提升显著 :MathTutorBench 脚手架胜率最高从 14% 升至 78.74%,证明教学行为可以被有效训练。
- 多规模适配不同场景 :4B、9B、27B 全覆盖,且 FP8 版本下载体积缩小 37%–44%,小模型可部署在学校普通服务器上。
OmniEdu的项目地址
- 项目官网 :https://haolpku.github.io/Omni-Edu/
- GitHub仓库 :https://github.com/haolpku/Omni-Edu
- HuggingFace模型库 :https://huggingface.co/datasets/lhpku20010120/Omni-Edu
- arXiv技术论文 :https://arxiv.org/pdf/2609.23088
OmniEdu的同类竞品对比
对比维度 | OmniEdu-27B | MuduoLLM(14B)
| 对比维度 | OmniEdu-27B | MuduoLLM(14B) |
|---|---|---|
| 模型规模 | 27B(另有 4B/9B 可选) | 14B(单一规格) |
| 模型定位 | 覆盖 K-12 学习-教学全流程(解题+课程理解+诊断+辅导) | 以学科解题和课程问答为主 |
| K12-Bench EM | 63.12% | 48.24% |
| MathFish 准确率 | 85.89% | 82.85% |
| EDUMATH MaC | 86.95% | 57.20% |
| GAOKAO-Bench | 94.87% | 89.66% |
| EXAMS-V | 69.52% | 21.95% |
| MDK12-Bench | 57.76% | 45.44% |
| MathTutor 脚手架胜率 | 78.74% | 30.42% |
| TutorBench | 59.42% | 35.98% |
| LongTutor Teaching | 3.02 | 1.28 |
OmniEdu的应用场景
- 个性化学习辅导 :学生做题时,模型先定位卡点,再通过提示和追问引导独立思考,适配自习场景。
- 错题诊断分析 :教师把学生的作答过程输入模型,自动分析错因、对应知识漏洞,生成针对性补救建议,减轻批改负担。
- 课程对齐内容生成 :教师按指定课程标准和年级生成练习题、分层作业或讲解材料,并自动标注知识点归属与前置关系。
- 课堂互动助教(苏格拉底式教学) :模型扮演助教,通过引导式提问推动学生推理,配合证据调整教学策略,支持分层教学。
相关工具
与本文相关的 AI 工具