Laya 开源的非自回归 AI 决策模型,Jev 开源平替
Laya是什么
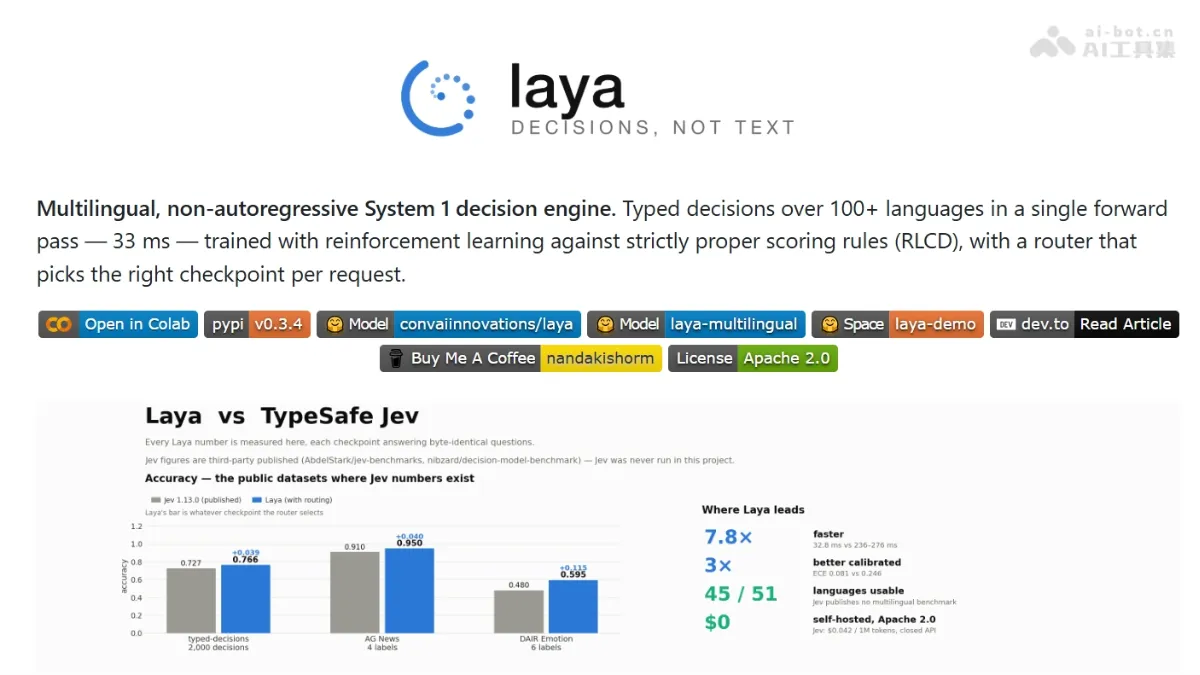
Laya 是开源的非自回归AI决策模型,模型不做文本生成,基于 ModernBERT/mmBERT 双向编码器,对一段文本加类型化问题只做一次前向传播,约 33ms 输出结构化结果与校准概率。模型内置语言路由支持 100+ 语言。相比闭源模型Jev,Laya在准确率(76.6% vs 72.7%)、多语言支持(100+语言)和成本(本地部署免费)上更具优势。
Laya的主要功能
单次前向决策 :输入一段状态加一组类型化问题,一次前向传播直接返回结构化结果,不做文本生成,约 33ms。
三种决策原语 :choice 从候选项中选一个并给出各项概率;score 在有序量表上打分并给出分布;noul 回答是非问题并返回 0–1 的成立概率。
语言自动路由 :Router 在 0.5ms 内检测输入脚本与语言,自动分发到英文或多语言 checkpoint,避免选错模型导致自信地答错。
置信度门控 :概率经 RLCD 训练具备统计意义,可按阈值把高置信决策自动放行、低置信转人工。
内置工作流预设 :提供模型路由、提示注入防护、内容安全审核、工单分诊等预置问题模板,开箱即用。
本地微调 :附带 Kaggle notebook,支持用自有数据完成造数据、RLCD 训练、温度拟合、评测的完整微调流程。
Laya的技术原理
双向非自回归架构 :基于 ModernBERT-large(421M)或 mmBERT-base(322M)双向编码器,输入 token 同时可见前后文;推理时不逐字生成文本,而是为每个候选选项分配独立 [MASK] 位,一次前向输出所有选项的 logits,经 Softmax 归一化为概率分布——这是 33ms 级延迟的来源。
RLCD 强化学习训练 :以对数评分、球面评分、等级概率评分等严格真评分规则作为奖励,模型只有在输出真实后验概率时才能获得高分,不确定时置信度自然降低,避免传统大模型盲目自信的问题。
语言路由机制 :Router 在 forward 之前用纯 Python 检测 Unicode 字符集与语言,据此选择 checkpoint;因为英文 checkpoint 在非拉丁文字上会以 0.95 置信度给出 0 准确率的答案,置信度本身无法预警,所以路由决策必须在推理前完成。
概率校准 :出厂 checkpoint 存在过度自信,需按(问题类型、选项数)在自有数据上拟合温度;拟合后平均 ECE 可从 0.466 降至 0.081,此时概率才可直接用于自动放行决策。
如何使用Laya
安装 : pip install laya ,PyPI 包,两天内从 0.1.0 更到 0.3.4,注意接口仍在变动。
加载模型 : Router(preload=True) 预加载三个 checkpoint,避免冷启动时每次切语言重建模型。
准备状态 :把要分析的文本组装成 dict,如 {"from": ..., "subject": ..., "body": ...} ,支持任意语言或 JSON 结构。
定义问题 :用 JSON 写一组类型化问题,指定 type(choice / score / noul)、instructions 和 criteria(选项或量表)。
执行预测 :调用 router.predict(state, questions) ,一次前向传播返回所有答案,英文走 laya、 Hindi 等自动走 multilingual。
读取结果 :从 res["answers"] 取 choice 标签、score 分值或 noul 概率, res["routing"] 会解释为什么选了这个 checkpoint。
置信度门控 :对 confidence 设阈值(如 0.85),高置信自动处理、低置信转人工——但前提是先在自己的数据上做过温度拟合。
Laya的核心优势
极速推理 :单次前向传播约 33ms(T4),批量低至 7.2ms/题,比闭源的 TypeSafe Jev 快约 7.8 倍。
零幻觉风险 :不生成文本、只输出结构化决策,没有解析负担,也不存在编造内容的问题。
概率可校准 :经 RLCD 严格真评分规则训练,置信度有统计意义,可直接驱动自动放行/人工复核流程。
校准精度领先 :温度拟合后 ECE 仅 0.081,优于 Jev 的 0.246,typed-decisions 准确率 0.766 也超过 Jev 的 0.727。
多语言路由 :内置 Router 亚毫秒级识别 100+ 语言并自动选 checkpoint,避免英文模型在非拉丁文字上自信地答错。
完全开源零成本 :Apache-2.0 协议、权重开放、可自托管,对比 Jev 的 $0.042/百万 token API 费用,长期使用成本为零。
输出类型化 :choice / score / noul 三种原语覆盖分类、打分、是非判断绝大多数结构化决策场景。
Laya的项目地址
GitHub仓库 :https://github.com/NandhaKishorM/laya
HuggingFace模型库 :https://huggingface.co/convaiinnovations/laya
Laya的同类竞品对比
维度 | Laya(开源) | TypeSafe Jev
维度 | Laya(开源) | TypeSafe Jev |
|---|---|---|
协议/权重 | Apache-2.0,权重完全开放 | 闭源,仅 API 调用 |
延迟(单题) | 32.8 ms(T4 实测) | 236–276 ms p50(第三方实测) |
typed-decisions 准确率 | 0.766(微调版) | 0.727 |
ECE 校准误差 | 0.081(温度拟合后) | 0.246 |
Banking77 高基数分类 | 0.425(77 选项,弱) | 0.870(72 选项,强) |
语言覆盖 | 100+ 语言,Router 自动分发 | 无公开多语言基准 |
成本 | 自托管 $0 | $0.042 / 1M tokens |
数据隐私 | 可完全本地跑,数据不出境 | 需上传至第三方 API |
软分布匹配(soft acc) | 0.471 | 0.580(更贴合教师分布) |
开箱即用性 | 基础模型零样本接近随机,需微调 | 商用 API,默认即可用 |
Laya的应用场景
客服工单自动分诊 :判断部门归属(billing/technical/sales)、紧急程度、用户挫败感和流失风险,高置信自动派单、低置信转人工。
内容安全与审核 :检测毒性、骚扰、威胁内容,noul 原语输出违规概率,适合社区和 UGC 平台实时审核。
提示注入防护(Guardrails) :在 Agent 系统入口检测越狱、注入、密钥泄露等攻击,33ms 级延迟可嵌入每次请求链路。
智能模型路由 :在混合大模型架构中判断请求该走小模型还是前沿模型,用极低成本完成调度决策,节省推理费用。