Grok 4.7 SpaceXAI 推出的最新旗舰大模型
Grok 4.7是什么
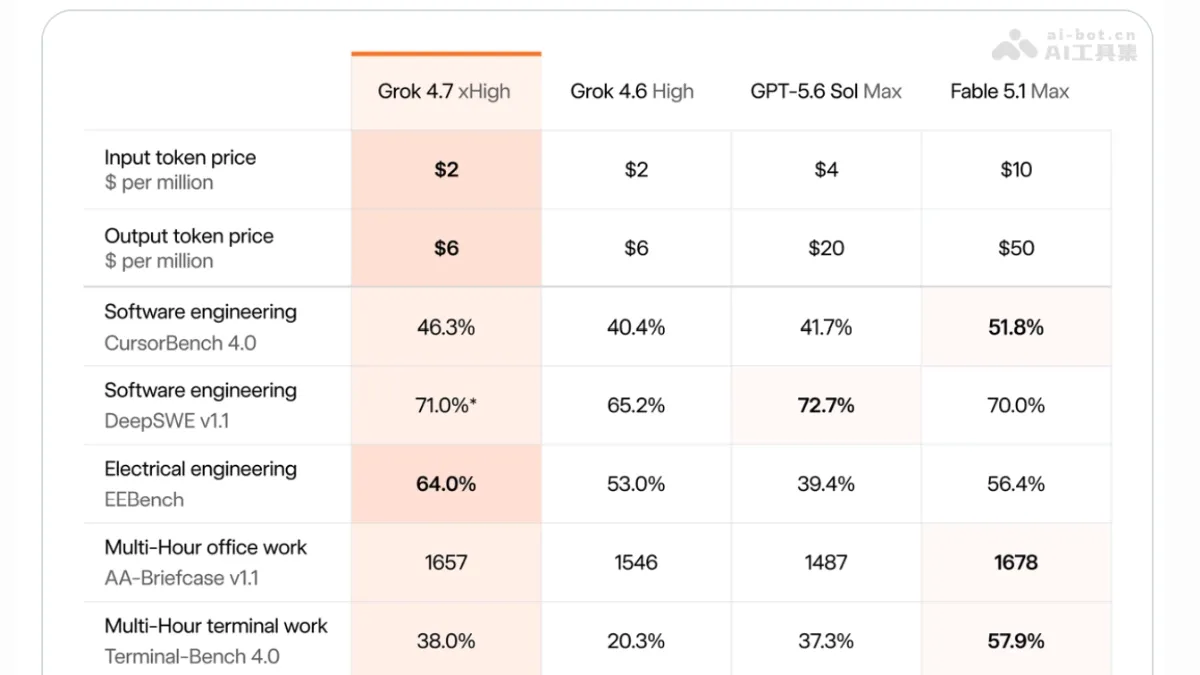
Grok 4.7 是 SpaceXAI 推出的最新旗舰大模型,定位为最强编码与知识工作模型。模型换用更大的基座模型,强化长程任务、自我验证与长上下文管理能力,在 CursorBench、Terminal-Bench、法律及电气工程等基准上大幅超越前代 Grok 4.6,价格维持每百万 token 输入 $2、输出 $6 不变,性价比突出。
Grok 4.7的主要功能
- 长程编码 :擅长持续数小时的复杂软件任务,能读仓库、拆需求、改多文件并反复纠错。
- 自我验证 :执行任务时可检查自身工作、管理长上下文,减少中途跑偏。
- 知识工作 :覆盖文档、演示文稿、法律分析、医疗推理、工程任务等专业场景。
- 四档推理 :支持 Low / Medium / High / Extra High 四档推理力度,按任务复杂度灵活选择。
- Fast 模式 :输出速度翻倍的快速变体,价格翻倍但仍远低于竞品。
- 安全护栏 :拒答与抗越狱能力为历代最强,生物安全与网络安全高风险拦截表现突出。
Grok 4.7的技术原理
如何使用Grok 4.7
- 网页/APP 体验 :访问Grok官网或下载 Grok App,登录 X 账号后在对话中选择 Grok 4.7 模型。
- Grok Build 更新 :本地终端用户执行 grok update ,将 Grok Build 升级到最新版即可使用。
- 选择推理档位 :在 Grok Build 中按任务复杂度切换 Low / Medium / High / Extra High 四档推理力度。
- Cursor 接入 :更新 Cursor 后,在模型设置中选择 Grok 4.7 作为编码模型。
- API 调用 :通过 Grok API(或第三方框架、模型路由、云平台)接入。
- Fast 模式 :追求速度时在 API 中选择 fast 变体,输出速度翻倍、价格翻倍。
Grok 4.7的核心优势
- 长程任务能力 :强化数小时级复杂任务的执行与自我纠错,大幅减少中途跑偏。
- 编码性能跃升 :CursorBench 达 46.3%(+5.9pt)、Terminal-Bench 翻倍至 38.0%,稳居第一梯队。
- 垂直领域领先 :法律基准 19.6%、电气工程 64.0%,大幅反超 GPT-5.6 Sol 与 Fable 5.1。
- 极致性价比 :输入 $2/输出 $6 每百万 token 与前代持平,价格仅为 Fable 5.1 的 1/5~1/8。
- 速度翻倍选项 :fast 变体输出速度翻倍,即使加价后仍远低于竞品。
- 免费换代升级 :用户无需为更强性能支付额外标准版成本。
- 安全最强一代 :拒答与抗越狱表现创官方纪录,LatchBio 62.4% 登顶。
- 全场景覆盖 :从编码延伸到文档、演示、法律、医疗、工程等完整知识工作流。
Grok 4.7的项目官网
- 项目地址 :https://x.ai/news/grok-4-7
Grok 4.7的同类竞品对比
| 对比维度 | Grok 4.7 | Claude Fable 5.1 |
|---|---|---|
| 定位 | 最强编码与知识工作模型 | 前沿旗舰通用模型 |
| CursorBench 4.0 | 46.3% | 🥇 51.8%(领先) |
| Terminal-Bench 4.0 | 38.0% | 🥇 57.9%(大幅领先) |
| DeepSWE v1.1 | 🥇 71.0%(反超) | 70.0% |
| Harvey 法律基准 | 🥇 19.6%(近 3 倍领先) | 6.7% |
| EEBench(电气工程) | 🥇 64.0%(明显领先) | 56.4% |
| AA Briefcase 办公任务 | 1657 分(接近) | 🥇 1678 分 |
| HealthBench Professional | 56.7%(偏弱) | 🥇 62.1% |
Grok 4.7的应用场景
相关工具
与本文相关的 AI 工具