WorkflowArena Navers Lab 推出的多智能体编排基准
WorkflowArena是什么
WorkflowArena 是 Einsia AI 旗下 Navers Lab 推出的多智能体编排基准,也是行业首个评测可执行工作流编排的基准。WorkflowArena 包含 145 项长程任务,覆盖软件工程、科学、数学、金融、法律、3D 制作等 8 大领域,只给目标、不规定分工,由模型自行决定如何调度子智能体,以隐藏判题器整体验收交付物。
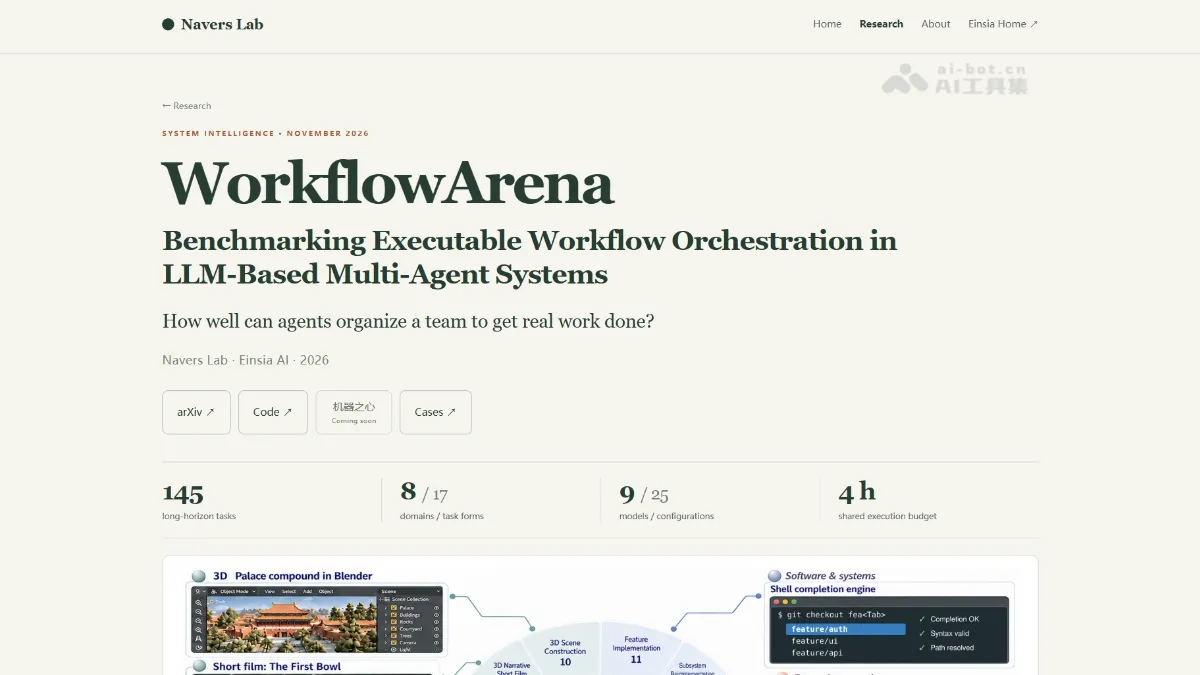
WorkflowArena的主要功能
- 评测多智能体编排能力 :考察大模型面对真实长程任务时,能否自行设计并执行有效的多智能体协作工作流。
- 提供 145 项专业交付任务 :覆盖 8 大领域、17 种任务形态,每题都是可验证的真实交付物。
- 开放式指挥台 :只规定目标,模型自行决定是否分工、如何调度子智能体、传递什么上下文,可随时查看、终止、修改工作流。
- 隐藏式整体判题 :判题器与标准答案对模型不可见,只看最终交付是否满足全部验收标准,与子智能体数量无关。
- 全程过程留痕 :完整记录每一次调度调用,使做得怎么样和怎么组织起来做的都能被分析。
- 支持编排迁移实验 :固定执行模型、只更换编写工作流的模型,可分离并量化编排能力本身的贡献。
- 成本与效果联合分析 :将完全解决率与单题推理成本对照,呈现各配置的性价比与帕累托前沿。
WorkflowArena的技术原理
- 任务构建:筛选可拆分但相互耦合的工作。 从真实素材出发,筛选那些各部分能分头完成、整合时必须相互对齐的任务,代码改动要通过回归测试、财务数据要跨主体对账、3D 部件要满足共享空间约束;随后只规定交付目标与验收标准,不规定工作流,并对整合后的交付物做校验。
- 评测协议:共享预算下的开放式编排。 每题从干净容器开始,隐藏测试与参考答案在 agent 工作区之外;主智能体与最多 16 个并发 worker 共享 4 小时执行预算,每个 worker 从全新上下文启动,编排者通过被记录的 Workflow 接口决定传递哪些信息,规划、调度、返工的时间成本全部计入。
- 计分体系:严格完全解决率 + 连续分。 主指标 Overall Resolved 取八大领域解决率的均值,只有满足该领域全部验收标准才算解决,各部分做对但未整合的提交判为失败;辅助指标 Overall Score 用 0–100 连续分记录部分进展,运营类任务还要求合法的操作历史。
- 编排能力分离实验:换脑不换手。 让编排者(如 Claude Opus 5.5)只写工作流和 worker 指令、不碰任何文件,实际工作全由执行模型完成,分静态(写完即离场)与动态(全程在线按反馈调整)两种模式。
如何使用WorkflowArena
- 克隆仓库 :执行 git clone https://github.com/Einsia/WorkflowArena.git 获取任务、评测与配置代码。
- 准备环境 :确保本机装有 Python 3.11+、Git 和 GitHub CLI,首次准备需联网。
- 下载冻结资产 :用 gh release download v1.0.0 下载科学计算输入文件和媒体镜像压缩包。
- 校验完整性 :在资产目录运行 shasum -a 256 -c SHA256SUMS ,核对全部文件的 SHA-256。
- 准备任务输入 :运行 scripts/prepare_inputs.py 验证哈希并把冻结数据链接进任务包。
- 加载媒体镜像 :构建内容与 3D 任务镜像前,先运行 load_images.py 载入冻结的媒体镜像。
- 校验数据集 :运行 scripts/verify_dataset.py ,拒绝缺失、被改动或未登记的文件。
- 组装任务 :运行 scripts/materialize_tasks.py ,生成 Harbor 兼容的任务目录。
- 构建任务镜像 :以各任务目录为上下文构建其 Dockerfile,得到 solver 容器环境。
- 接入执行框架 :在 Harbor 兼容的 runner 中启动 agent。
- 运行隐藏评测 :判题文件位于 solver 不可见的 tests/ 侧,按验收标准对整合交付物自动判分。
- 查看结果 :对照 results/ 中的论文汇总表与 Results CSV,按 Overall Resolved或 Overall Score 解读表现。
WorkflowArena的核心优势
- 真实长程专业交付 :145 项任务全部来自真实工作场景,交付物环环相扣,必须整合到位才算通过。
- 不规定分工的开放评测 :由模型临场决定要不要分工、怎么调度,测的是真编排能力。
- 结果与过程双记录 :隐藏判题保证评分只看交付质量,同时完整留痕每次调度,可分析怎么组织起来做的。
- 严格且细粒度的计分 :完全解决率要求满足全部验收标准,辅以 0–100 连续分记录部分进展,杜绝差不多算过。
- 编排能力可分离测量 :固定执行模型、只换编排者的迁移实验,首次把编排贡献从执行能力中解耦量化。
- 成本效益全景对照 :将解决率与单题推理成本联合呈现帕累托前沿,揭示决定上限的是编排而非烧钱。
WorkflowArena的项目地址
- 项目官网 :https://lab.einsia.ai/workflowarena
- GitHub仓库 :https://github.com/Einsia/WorkflowArena
- arXiv技术论文 :https://arxiv.org/pdf/2611.12856
WorkflowArena的同类竞品对比
| 维度 | WorkflowArena | SWE-bench |
|---|---|---|
| 核心问题 | 模型能否自己组织多智能体系统完成长程任务 | 模型能否单打独斗解决真实 GitHub issue |
| 任务规模 | 145 项任务,8 大领域、17 种形态 | 原始 2,294 个 issue(Verified 子集 500 个) |
| 领域覆盖 | 软件工程、企业运营、科学、数学、金融、法律、内容设计、3D 制作 | 仅软件工程(Python 开源库) |
| 协作结构 | 不预设,模型自行编排、可调度最多 16 个 worker | 单 agent,无编排维度 |
| 判题方式 | 隐藏判题器整体验收交付物 + 过程留痕 | 公开单元测试(FAIL_TO_PASS / PASS_TO_PASS) |
| 主要指标 | Overall Resolved(完全解决率)+ Overall Score(连续分) | Resolved rate(测试通过率) |
| 过程可分析性 | 每次调度完整记录,可对比编排风格与成本 | 基本只看最终补丁是否通过测试 |
| 能力解耦实验 | 内置”换编排者”迁移实验,量化编排本身的价值 | 无此设计 |
| 结果区分度 | 最强系统仅 36.95%,远未饱和 | 头部系统已接近高分区间,趋于饱和 |
| 开放性 | GitHub 开源任务与评测材料,论文已挂 arXiv | 开源,生态成熟(已有 leaderboard) |
WorkflowArena的应用场景
相关工具
与本文相关的 AI 工具