Nemotron 3.5 Transcribe 英伟达开源的语音大模型
Nemotron 3.5 Transcribe是什么
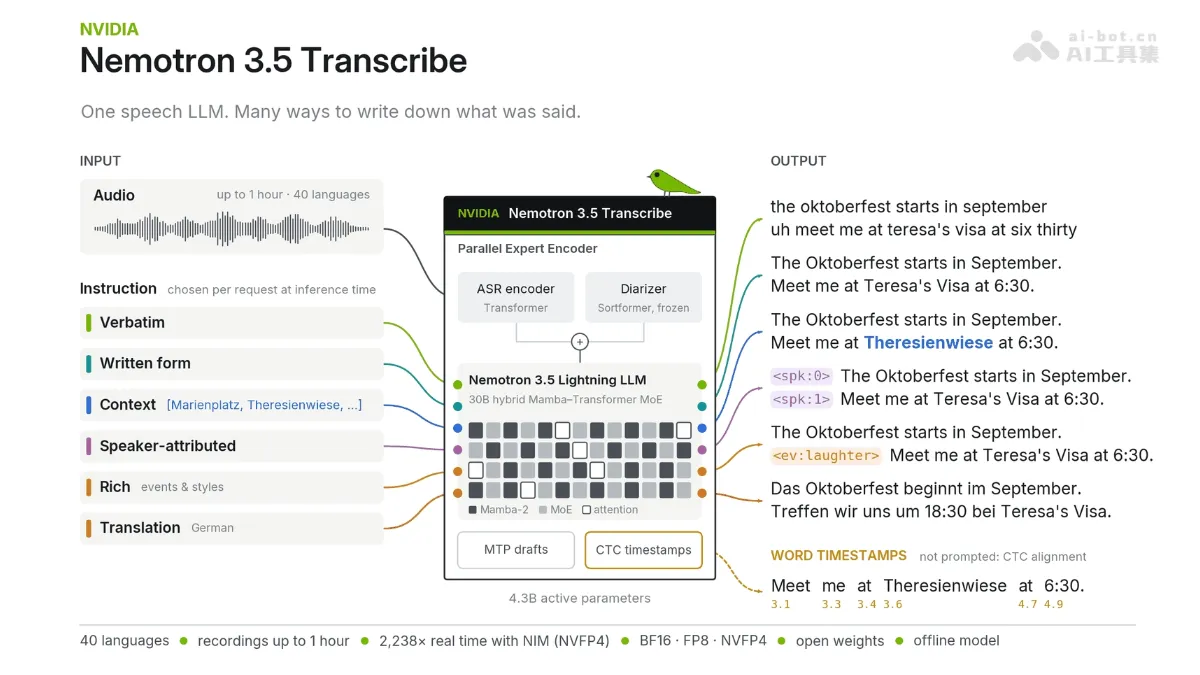
Nemotron 3.5 Transcribe 是英伟达推出的开源语音大模型,采用语音编码器加 MoE 架构,约 43 亿活跃参数,支持 40 种语言,可处理最长 1 小时、最多 8 人讲话的录音,覆盖逐字转写、说话人区分、翻译等功能。Nemotron 3.5 Transcribe 支持用自然语言指令定制输出格式,通过微调适配专业领域,商业使用免费。
Nemotron 3.5 Transcribe的主要功能
多语言转写 :支持 40 种语言,可将录音转写为文字,能识别口语中的语言种类。
说话人区分 :能分辨最多 8 位说话人,为每句话标注归属,适用会议和多人访谈。
长音频处理 :单次可处理最长约 1 小时的录音。
指令化转写 :用自然语言指定输出格式,逐字稿、书面化整理、清理口头禅、术语写法等,无需重新训练。
语音翻译 :可在 31 种语言与英语之间互译。
词级时间戳 :返回每个词对应的音频时间位置,便于回听和检索。
领域微调 :基于 NeMo Speech 工具包,可在单 GPU 上用少量数据快速适配专业场景。
Nemotron 3.5 Transcribe的技术原理
语音增强语言模型(SALM) :模型由三部分组成,Transformer 语音编码器负责提取音频特征,一个冻结的 Nemotron 3 说话人分离模型提供说话人活动信息,两者共同接入 Nemotron 3.5 Lightning 30B-A3B 混合 Mamba-Transformer MoE 大语言模型。总参数约 340 亿,但每次推理只激活约 43 亿参数,兼顾能力与效率。
并行专家编码器 :frozen 分离模型输出的说话人活动信号被注入到 ASR 编码器的表征中,使模型在单一 LLM 架构下无需改动就能完成带说话人标注的转写,并通过序列化输出方式训练。
监督均衡混合 :训练数据按答案 token 量非样本数来采样,每条 ASR 样本可搭配多种任务指令使用,使新能力只需不到 1% 的采样率即可加入,整个训练分为监督微调和一段短的强化学习两个阶段,后者直接优化转写准确率。
MTP 投机解码 :模型在训练时联合优化多 token 预测(MTP)目标,因此自身的 MTP 层可直接充当 vLLM 投机解码的草稿模型;同时还单独提供一个 DFlash2 草稿模型作为备选。两者配合可在单张 RTX PRO 6000 Blackwell GPU 上达到每秒转写 2238 秒音频的吞吐。
CTC 时间戳适配器 :解码后用一个轻量 CTC 适配器将生成的文本与音频对齐,为长音频和重度重叠对话产出带说话人标注的词级时间戳,不增加主模型负担。
如何使用Nemotron 3.5 Transcribe
准备硬件 :BF16 版需约 80GB 显存,可选 FP8/NVFP4或 GGUF 版降低门槛。
获取模型 :在 Hugging Face 或魔搭搜索 NVIDIA-Nemotron-3.5-Transcribe-30B-A4B ,按 OpenMDW-1.1 许可下载权重。
安装环境 :部署方式三选一,Nemotron Transcribe NIM(官方容器)、vLLM(支持 MTP 加速)、或 NeMo-Speech.cpp(GGUF 本地运行)。
准备音频 :上传最长 1 小时的录音文件,格式按所用框架要求转换。
写提示词 :用自然语言说明任务,如保留逐字原话并标注说话人清理口头禅并翻译为英文。
运行推理 :调用接口提交音频与提示词,模型返回转写文本,必要时附带说话人标签和词级时间戳。
(可选)快速体验 :不想部署可先用 Hugging Face 上的 nvidia/nemotron-transcribe 体验空间在线试用。
(可选)领域微调 :用 NeMo Speech 工具包准备标注数据,单 GPU 约 0.5–2.3 小时即可适配自有口音、术语和格式。
Nemotron 3.5 Transcribe的核心优势
指令化输出 :用一句自然语言能切换逐字稿、整理稿、翻译等不同形式,无需重新训练或配置多个模型。
强转写精度 :英语 Open ASR 榜单平均 WER 仅 4.71%,多语言榜单 4.62%,均为开放权重模型第一。
领先的说话人区分 :在重叠多人语音的标注转写任务上首次超越专用级联系统,且最长支持 1 小时、8 人场景。
上下文纠错能力强 :给定术语、人名等实体列表后,命名实体错误率可降低 6 倍,专业词不再靠猜。
带说话人标注的词级时间戳 :轻量 CTC 对齐让转写结果可回听、可检索,直接支撑课程回放、会议检索等应用。
推理效率高 :原生 MTP 投机解码加 DFlash2 草稿模型,单张 RTX PRO 6000 每秒可处理 2238 秒音频。
Nemotron 3.5 Transcribe的项目地址
HuggingFace模型库 :https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
技术论文 :https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3.5-Transcribe-Technical-Report.pdf
Nemotron 3.5 Transcribe的同类竞品对比
对比维度 | NVIDIA Nemotron 3.5 Transcribe | OpenAI GPT-Realtime-Whisper |
|---|---|---|
产品形态 | 开放权重模型,可自部署/商用 | 云端 API,仅按量付费调用 |
模型架构 | SALM:语音编码器 + 冻结分离模型 + 30B-A3B Mamba-Transformer MoE LLM(活跃约 4.3B) | OpenAI 未公开,属 Whisper 家族流式版本 |
处理方式 | 离线批处理(录好的音频) | 流式实时转写,边说边出字幕 |
语言支持 | 转写 40 种,翻译 31 种 | 未完整公开(Whisper 家族约 99 种,官方未给流式版确切数) |
说话人区分 | ✅ 原生集成,重叠语音超专用级联系统 | ⚠️ 未作为核心能力宣传 |
指令化输出 | ✅ 自然语言自由定制逐字稿/整理稿/翻译格式 | ⚠️ 功能聚焦实时字幕,无自由格式指令 |
词级时间戳 | ✅ 带说话人标注(CTC 对齐) | ✅ 流式场景下输出分段文本 |
长音频 | 单次最长约 1 小时 | 无单次时长限制(持续流式) |
目标场景 | 会议整理、访谈归档、领域定制等离线深度处理 | 直播字幕、会议实时记录、语音工作流更新 |
Nemotron 3.5 Transcribe的应用场景
会议纪要与决策提取 :自动区分发言人、保留讨论原话,并按指令提炼会议结论和待办事项。
媒体访谈与新闻采编 :逐字保留受访者原话并标注说话人,确保引述准确,同时可按需清理口头禅。
课堂与培训回放 :生成带词级时间戳的转录稿,让学生直接搜索关键词并跳转到老师讲该知识点的时刻。
医疗与专业领域记录 :结合术语列表和领域微调,将医患对话按规范格式转写为病历文本,降低专业词汇错误率。
多语言内容本地化 :将 40 种语言的录音直接翻译输出为英文稿,用于跨国会议、访谈或视频字幕制作。