Kev 开源的 Jev 风格决策模型家族,可自训练、自部署
Kev是什么
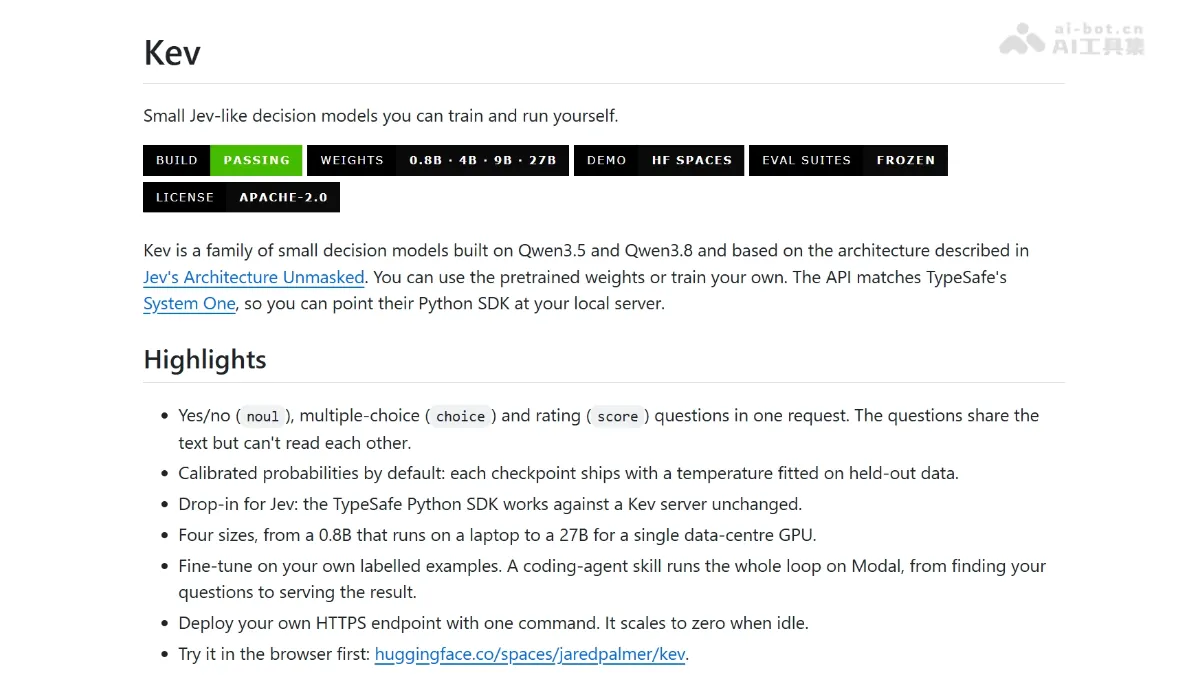
Kev是Cognition工程VP Jared Palmer开源的决策模型家族,基于Qwen3.5/Qwen3.8,提供0.8B至27B多档模型。Kev不生成文字,输入状态文本加结构化问题,单次前向直接输出校准概率,支持是/否、选项路由、等级打分三类决策,API兼容TypeSafe System One。
Kev的主要功能
结构化决策 :输入一段状态文本加若干结构化问题,一次请求直接输出每个选项的校准概率,永不生成解释性文字。
三类决策原语 :支持 noul 、 choice 、 score 。
批量提问隔离 :多个问题共享同一份输入状态,通过注意力掩码互相隔离,一次前向传播同时回答所有问题且互不污染。
本地部署 :提供 kev.serve 一行命令起服务,暴露 POST /v1/systemone 端点,兼容 CUDA、ROCm 和 Apple Silicon(MLX)。
低成本微调 :支持用自有标注数据基于官方 checkpoint 继续训练,配套 kev-finetune skill 让 coding agent 自动完成数据整理、训练、评估、部署全流程。
自带评估体系 :内置冻结评测集,报告准确率、Brier分数、校准误差和可自动化决策比例,且 CI 自动校验发布数字。
Kev的技术原理
指针头把生成变判别 :Kev 冻结 Qwen 基座权重,外挂一个 rank-16 LoRA 适配器和指针头。每个候选项的 /opt 隐藏状态与问题的 decide 隐藏状态做打分,过 softmax 得到概率,本质是把大模型的写作题改造成选择题,跳过逐 token 生成。
块因果注意力实现问题隔离 :输入序列组织为状态 + 多个问题块,注意力掩码让每个 token 只能读到状态和本问题内部,位置 ID 在每个问题处重新计数,因此一次前向可同时回答多个互不相关的问题,共享状态计算且彼此不泄露信息。在 Qwen3.5/3.8 这类混合 Gated DeltaNet 的模型上,则改为每问题独立成行、复用状态 KV 缓存,隔离更严格。
训练与校准 :用交叉熵在正确标签上训练 adapter 和指针头,基座全程冻结;每个 checkpoint 在留出数据上拟合一个温度参数,推理时直接输出校准后概率,且温度不改变排序,只校准置信度数值。
如何使用Kev
环境准备 :安装 Python 3.12/3.13 和 uv,克隆仓库后执行 uv sync --extra serve 安装依赖。
本地启动服务 :运行 KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009 启动模型,首次运行自动下载权重。
发送决策请求 :向 POST /v1/systemone 提交 state 文本和 questions,返回各选项的校准概率。
Python SDK 调用 :用 TypeSafe 官方 SDK 将 base_url 指向本地服务,已有 Jev 应用零改动切换。
浏览器试玩 :访问 Hugging Face Space或本地运行 playground,无需安装即可体验。
微调自有数据 :整理 JSONL 格式的标注数据,用 uv run python -m kev.train --init_from jaredpalmer/kev-4b ... 基于官方 checkpoint 继续训练。
Agent 全自动微调 :执行 npx skills add jaredpalmer/kev@kev-finetune 后让 coding agent 完成找问题、造数据、训练、评估、部署全流程,无需本地 GPU。
云端部署 :执行 pip install modal modal deploy kev_serve.py 一键部署 HTTPS 端点,闲置时自动缩容到零不计费。
评估验证 :用 uv run python -m kev.benchmark --run 模型 --suite evals/v4/transfer-v4 在冻结评测集上验证效果,先评测再上线。
Kev的核心优势
极低成本 :单次前向传播直接输出概率,省去逐 token 生成,H100 上答 6 个问题仅 18ms,自建后零调用费。
训练便宜可复现 :官方三档移植训练仅花约 95 美元,个人微调一次约 1 美元,完整账单公开透明。
开源可控 :Apache-2.0 协议下权重、训练代码、冻结评测集全部公开,可自训、可审计、无供应商锁定。
API 即插即用 :完全兼容 TypeSafe System One,已有 Jev 应用改个 base_url 即可零改动切换。
多问题一次搞定 :共享输入状态、块因果注意力隔离,一次前向同时回答任意数量问题,互不污染。
Kev的项目地址
GitHub仓库 :https://github.com/jaredpalmer/kev
Kev的同类竞品对比
对比维度 | Kev(开源) | Jev
对比维度 | Kev(开源) | Jev |
|---|---|---|
性质 | 开源模型家族,Apache-2.0 | 闭源商业 API |
架构 | Qwen3.5/3.8 基座 + LoRA + 指针头 | 未公开(Kev 参考其架构思路复现) |
模型档位 | 0.8B / 4B / 9B / 27B 可选 | 单一托管模型 |
新来源准确率 | 27B 0.848,4B 0.838,9B 0.852 | 0.857(开发集) |
校准质量 | 置信错误率 4.0%,5%错误预算下自动化 0.45~0.57 | 置信错误率 3.7%,自动化 0.70 |
速度 | H100 上 6 问 18ms,可自建批量推理 | 受 API 网络延迟限制 |
成本 | 权重免费,自托管零调用费;微调约 $1/次 | 按调用付费 |
数据隐私 | 完全本地/自有服务器,数据不出境 | 数据经过第三方 API |
Kev的应用场景
客服工单路由 :一次前向同时判断转哪个部门、要不要升级人工、客户愤怒等级,按概率阈值自动分流,低置信转人工。
内容安全审核 :对 UGC 文本并行执行noul 是否违规 + choice 违规类型 + score 严重程度,高置信自动处置。
金融/信贷初审 :判断投诉类型、是否需要人工介入、风险等级,概率分布辅助合规留痕与人工复核优先级排序。
电商商品/意图分类 :将用户查询路由到搜索、推荐或售后等下游系统,处理一个词踩多个类目的多标签分布问题。