Iris 小红书 AllSpark 团队开源的搜索智能体
Iris是什么
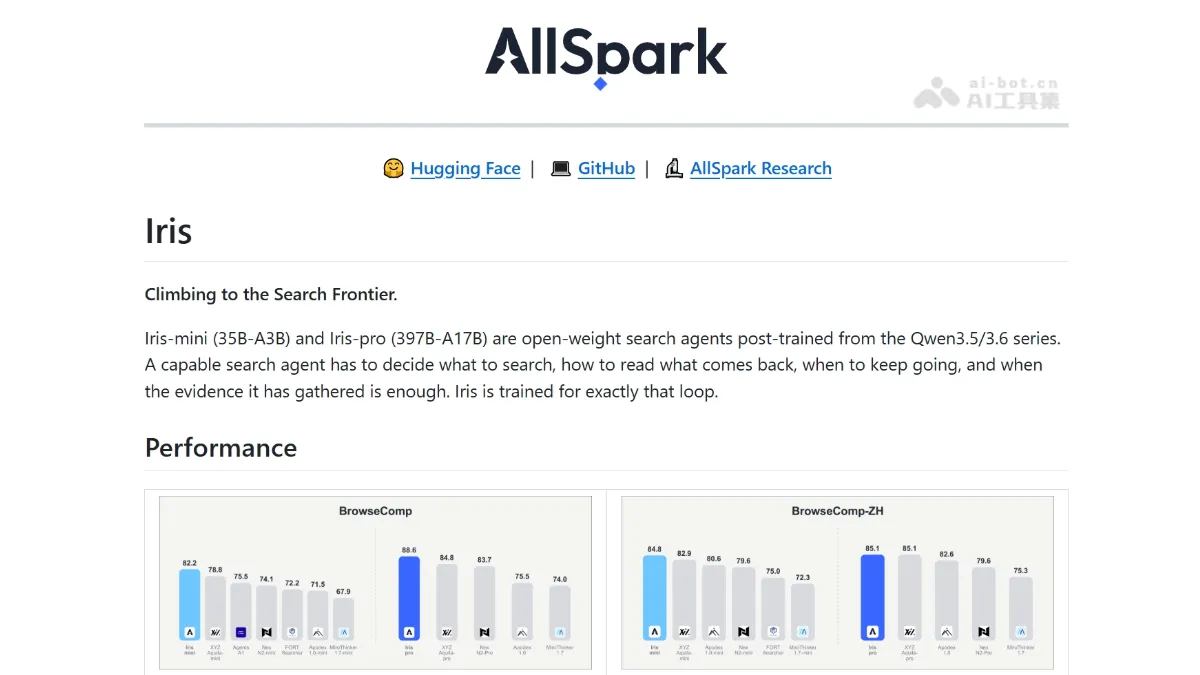
Iris 是小红书 AllSpark 团队开源的搜索智能体,含 35B(Iris-mini)和 397B(Iris-pro)两个版本。Iris能在真实网络中自主决定搜什么、怎么读、何时收敛作答,通过从网页超链接反向构造够难且可解的训练数据,采用 SFT 与强化学习交替的SFT–RL Climbing训练法。在 BrowseComp、DeepSearchQA、HLE 等四大基准上取得同量级最强开源成绩,35B 版本已逼近万亿参数模型,搜索能力可外溢到通用工具调用等任务。
Iris的主要功能
- 自主网络搜索 :自己决定搜什么、如何阅读检索结果、何时继续或停止,边搜边推理边作答。
- 多步跨页推理 :能多个网页逐步锁定唯一答案,而非靠关键词匹配走捷径。
- 中英文复杂检索 :在 BrowseComp、BrowseComp-ZH 等中英文网页检索任务上均达到同量级开源最强。
- 证据覆盖型问答 :回答时完整覆盖证据链,在 DeepSearchQA 上表现领先。
- 专家级难题求解 :能处理 HLE 这类需要专家级推理的高难度问题。
- 上下文管理 :支持截断、压缩等上下文管理策略,长链路搜索不中断,小模型获益尤为明显。
- 能力外溢 :未经专门训练即可胜任通用工具调用和办公协作等任务。
Iris的技术原理
- 反向造题的数据构造 :以种子页面为答案,顺超链接聚成实体图谱,在图谱上生成必须跨页多步推理的题目,再把题面中答案以外的实体改写成描述性指代以抹掉可匹配的线索,最后用参考模型双重筛选,闭卷答不出、给证据能唯一答对才保留,全程自动化、可随语料规模扩展。
- SFT–RL Climbing 交替训练 :SFT 阶段用强教师模型在真实搜索工具上生成轨迹,经结果过滤和判官单步过滤后训练;RL 阶段让模型在真实网络边搜边学,每轮结束后把最难做对和最高效解出的轨迹回灌下一轮 SFT,随模型变强题目自动变难,形成自适应课程。
- 训练工程内化 :判分与摘要用自建模型在训练集群内部完成,不依赖任何外部 API,避免网络波动干扰训练循环;同时训练与线上使用同一套摘要器,消除训练与推理的错位。
- 超长轨迹断点续跑 :少数拖后腿的超长会话不再整段丢弃,在请求级别中断、下一步从已提交前缀继续,使 GPU 在同步调度下保持高利用率。
- 对齐式评测协议 :所有对比系统在相同工具、上下文、判分模型及同一上下文管理策略下、仅用单 ReAct 智能体评测,排除多智能体和测试时自我验证等框架取巧,让分数真实反映模型本身能力。
如何使用Iris
- 克隆代码仓库 :执行 git clone https://github.com/AllSpark-Research/Iris 获取推理与评测代码。
- 下载模型权重 :从 HuggingFace 集合 huggingface.co/collections/AllSpark-Research/iris 下载 Iris-mini(35B)或 Iris-pro(397B)权重。
- 配置运行环境 :按仓库要求安装依赖(如 vLLM/SGLang 等推理框架),并配置好搜索工具接口(联网检索是 Search Agent 的必要前提)。
- 加载模型并接入工具 :用 ReAct 智能体形式加载模型,将搜索引擎作为工具注册给模型调用。
- 提出问题运行推理 :输入问题,模型会自动规划搜索查询、阅读网页、多步推理并收敛给出带证据的答案。
Iris的核心优势
- 同量级最强开源成绩 :在 BrowseComp、BrowseComp-ZH、DeepSearchQA、HLE 四个搜索基准上全面领先同量级开源模型,397B 的 Iris-pro 部分项目反超万亿参数级模型。
- 小体量逼近超大模型 :35B 的 Iris-mini 在 BrowseComp 上拿下 82.2 分,已逼近 Kimi-K2.6 等数十倍参数量的模型,让小模型在垂域上具备挑战超大模型的能力。
- 数据构造自动化且高质量 :从网页超链接反向造题、抹掉可匹配线索、双重筛选够难且可解,全程无需人工出题,可随语料规模无限扩展。
- 训练工程稳健高效 :判分与摘要内化到训练集群,彻底摆脱外部 API 依赖;超长轨迹断点续跑让 GPU 持续满载,大幅降低训练不确定性。
- 训练与线上一致 :训练时压缩检索内容的摘要器与评测、线上使用的是同一套,不存在训练与使用的错位。
- 能力外溢,通用性强 :搜索能力泛化到通用工具调用和办公协作等从未专门训练的任务,Search 是可复用的原子能力。
Iris的项目地址
- GitHub仓库 :https://github.com/AllSpark-Research/Iris
- HuggingFace模型库 :https://huggingface.co/collections/AllSpark-Research/iris
- arXiv技术论文 :https://arxiv.org/pdf/2609.04304
Iris的同类竞品对比
对比维度 | Iris(小红书 AllSpark) | Kimi-K2.6(月之暗面)
| 对比维度 | Iris(小红书 AllSpark) | Kimi-K2.6(月之暗面) |
|---|---|---|
| 模型定位 | 开源 Search Agent 专用模型 | 万亿参数通用大模型(兼具 Agent 能力) |
| 参数规模 | Iris-mini 35B(MoE 激活 3B)/ Iris-pro 397B(MoE 激活 17B) | 约 1T 参数 |
| BrowseComp | mini 82.2 / pro 88.6 | 单智能体 83.2 / Agent Swarm(300 子智能体)86.3 |
| 参数效率 | 35B 体量即逼近 K2.6 万亿级单智能体水平 | 需 1T 参数达到相近水平 |
| 开放性 | 权重、评测代码、数据构造与训练配方全部开源 | 开源权重,但数据与训练细节未公开 |
| 评测公平性 | 统一工具/上下文/判分模型,单 ReAct 无框架取巧 | Agent Swarm 依赖多子智能体加成,协议不同难直接对齐 |
| 能力外溢 | 未专门训练即可胜任 BFCL、τ-bench、OfficeQA、APEX | 通用模型,工具调用为通用能力而非专门外溢 |
Iris的应用场景
- 深度研究/调研报告 :自动多轮检索、跨页推理、证据覆盖完整,适合行业研究、竞品分析、学术调研等 Deep Research 类产品。
- 复杂事实核查 :答案需跨多个网页多步锁定,适合辟谣、事实核查、尽职调查等必须找到出处的场景。
- 中英文双语搜索 :BrowseComp 与 BrowseComp-ZH 双优,天然适合中英混合语料的跨境信息检索。
- 通用工具调用智能体 :能力外溢至 BFCL、τ-bench 等 General Tool Use 任务,可作为 Agent 产品的通用底座。
- 办公协作(Cowork) :在 OfficeQA、APEX 等办公任务上无需专门训练即可上手,适合嵌入办公助手处理文档问答与流程任务。
相关工具
与本文相关的 AI 工具