HiDream-O1-Video-1.0 智象未来推出的全模态视频生成模型
HiDream-O1-Video-1.0是什么
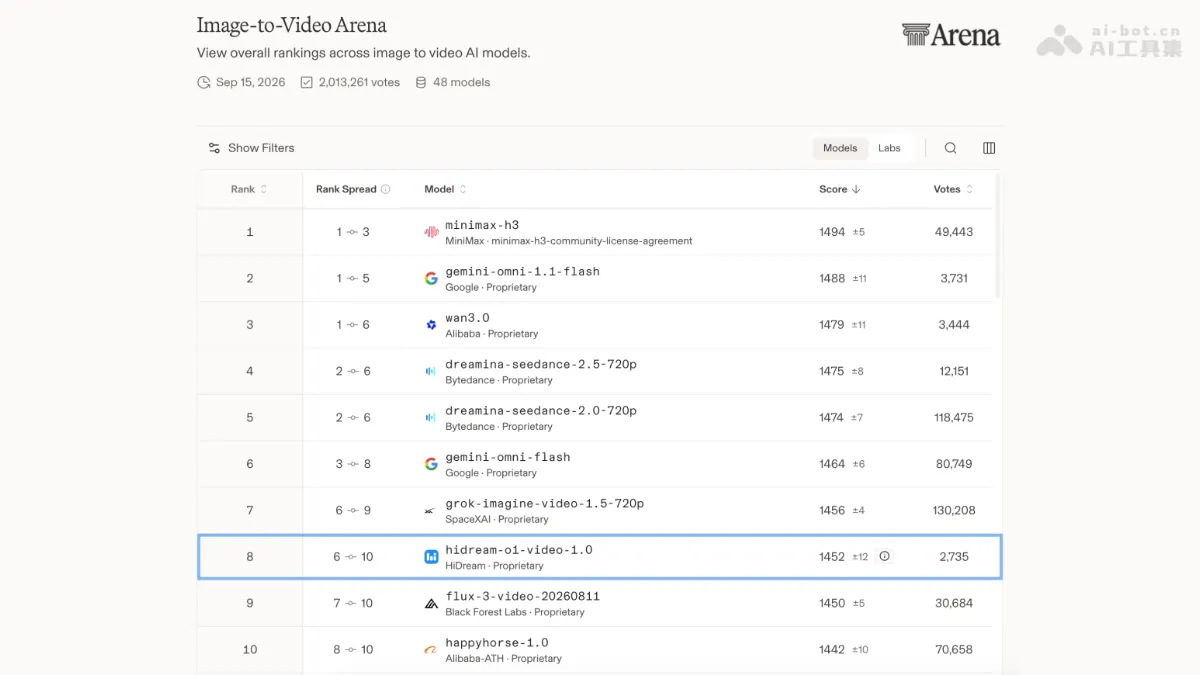
HiDream-O1-Video-1.0(简称HD-V1)是智象未来(HiDream.ai)推出的原生全模态视频生成模型,支持文本、图片、视频等多模态输入,可一键直出5–20秒1080p视频。模型在物理规律导向生成与音画原生一体化,在Artificial Analysis图生视频榜(With Audio)排名全球第四、Arena.ai盲测榜第八,标志中国AI视频进入全球第一梯队。
HiDream-O1-Video-1.0的主要功能
多模态输入 :支持文本、图片、视频等多种模态作为生成条件。
高保真视频直出 :一键生成5–20秒1080p高画质视频。
意图理解 :前置多模态理解模块,将口语化输入结构化规划为镜头、角色、动作、音效等专业方案。
物理规律生成 :重力、碰撞、惯性等物理规律被写入生成逻辑,画面形变与运动贴合真实世界。
智能时长规划 :根据事件逻辑与叙事节奏自动决定视频时长,而非机械填充固定窗口。
音画一体化 :文本、视频、音频信号联合建模,实现口型、音效与画面的原生同步。
叙事与人物一致性 :采用先规划、后联合生成、再Reward对齐流程,保证长镜头叙事连贯、人物不漂移。
HiDream-O1-Video-1.0的技术原理
原生全模态统一架构 :HD-V1 采用智象自研的原生全模态架构,在架构设计之初即面向文本、视频与音频的统一表征,三者在同一生成过程中联合建模、相互约束与对齐,画面运动牵引声音节奏,台词音效反哺镜头情绪,文本条件贯穿始终。
前置多模态意图理解模块 :模型首先借助多模态理解模型对用户输入进行深度理解与结构化规划,将口语化、模糊化的自然语言转换为镜头时长、场景地点、在场角色、动作表情、景别构图、运镜焦段、台词与背景声等专业字段。理解越深则规划越稳,规划越稳则后续联合生成越不容易跑偏,从源头避免意图漏解、镜头跳戏和人物漂移。
物理规律内生的生成逻辑 :物体受重力如何下落、碰撞如何反馈、惯性如何延续、光影如何衰减、空间如何保持连续。
规划—生成—对齐的三段式生成流程 :智象提出先规划、后联合生成、再以多模态Reward对齐的技术思路:模型先在全局层面规划叙事与角色状态,联合生成中约束画面、动作与语义,用多模态奖励信号对画质、连贯性与物理合理性进行统一对齐,保证长镜头中人物、情绪、动机互相影响下的整体自洽。
如何使用HiDream-O1-Video-1.0
确认开放状态 :目前模型处于内测阶段,尚未全面公开上线,需申请提前体验资格https://n1y46cmwsp.feishu.cn/share/base/form/shrcnVBeO99NQQWARxNirglcbct。
扫码填写申请表 :长按扫描二维码,进入申请表页面。
提交申请信息 :按表单要求填写个人/企业信息及使用需求,提交后等待官方审核。
等待开通通知 :审核通过后将获得内测体验资格。
体验模型能力 :获得资格后,可通过官方提供的入口输入文本、图片或视频,一键生成5–20秒1080p音画一体视频。
HiDream-O1-Video-1.0的核心优势
原生全模态架构 :业内首个对文本、视频、音频信号联合建模的视频模型,音画原生一体化生成。
物理规律导向生成 :重力、碰撞、惯性、光影衰减、空间连续性等物理规律被模型真正理解并写入生成逻辑,画面形变、运动反馈、拟音效果均贴合真实因果。
深度意图理解 :前置多模态意图理解模块,将口语化、碎片化的用户输入结构化规划为镜头时长、景别构图、运镜、动作表情、台词音效等专业方案,从源头避免意图漏解和镜头跳戏。
时长服从叙事 :打破固定时长窗口填充内容的传统逻辑,由模型根据事件发展逻辑和叙事节奏自主规划时长,避免动作完成后的无意义等待或慢放凑数。
叙事连贯与人物一致 :采用先规划、后联合生成、再以多模态Reward对的技术路径,配合Diffusion RL和人工认知对齐的Reward模型,保证连续镜头中人物、情绪、动机自洽不漂移。
HiDream-O1-Video-1.0的同类竞品对比
对比维度 | HiDream-O1-Video-1.0(智象未来) | Google Veo 3.1(DeepMind) |
|---|---|---|
原生音画同步 | ✅ 文本/视频/音频联合建模,原生一体化 | ✅ 同步生成对白、音效、环境音,误差<0.1秒 |
生成时长 | 5–20秒,时长由内容自主规划 | 单段4–8秒,经延展最长148秒 |
输出规格 | 1080p | 720p/1080p,企业版4K超分 |
物理规律 | ⭐ 核心卖点:物理规律写入生成逻辑(重力/碰撞/惯性/光影) | 物理模拟较强,但非架构级核心叙事 |
意图理解 | ⭐ 前置多模态意图模块,结构化规划镜头/音效等字段 | 依赖Gemini提示词理解,控制项较少,无镜头控制系统 |
多模态输入 | 文本、图片、视频 | 文本、最多3张参考图、视频扩展 |
榜单成绩 | Artificial Analysis图生视频(With Audio)全球第四;Arena.ai盲测第八 | Artificial Analysis文生视频ELO约1098 |
HiDream-O1-Video-1.0的应用场景
广告与营销短片 :音画一体直出1080p产品视频,省去后期配音成本,物理真实的材质表现适配高质感商品展示。
短视频/社媒内容创作 :5–20秒自适应时长天然匹配短视频节奏,口语化提示词即可生成带音效、口型同步的成片。
影视预演与分镜(Previs) :结构化规划镜头、景别、运镜和音效,帮助导演在拍摄前快速验证叙事节奏和画面可行性。
电商产品动态展示 :输入商品图即可生成使用场景视频,物体物理运动真实,拟音同步提升转化率。
教育与科普内容 :将碎片化知识点转化为物理规律准确的动态演示,音画同步降低理解门槛。