TalkLikeYou 中科院自动化所开源的实时数字人框架
TalkLikeYou是什么
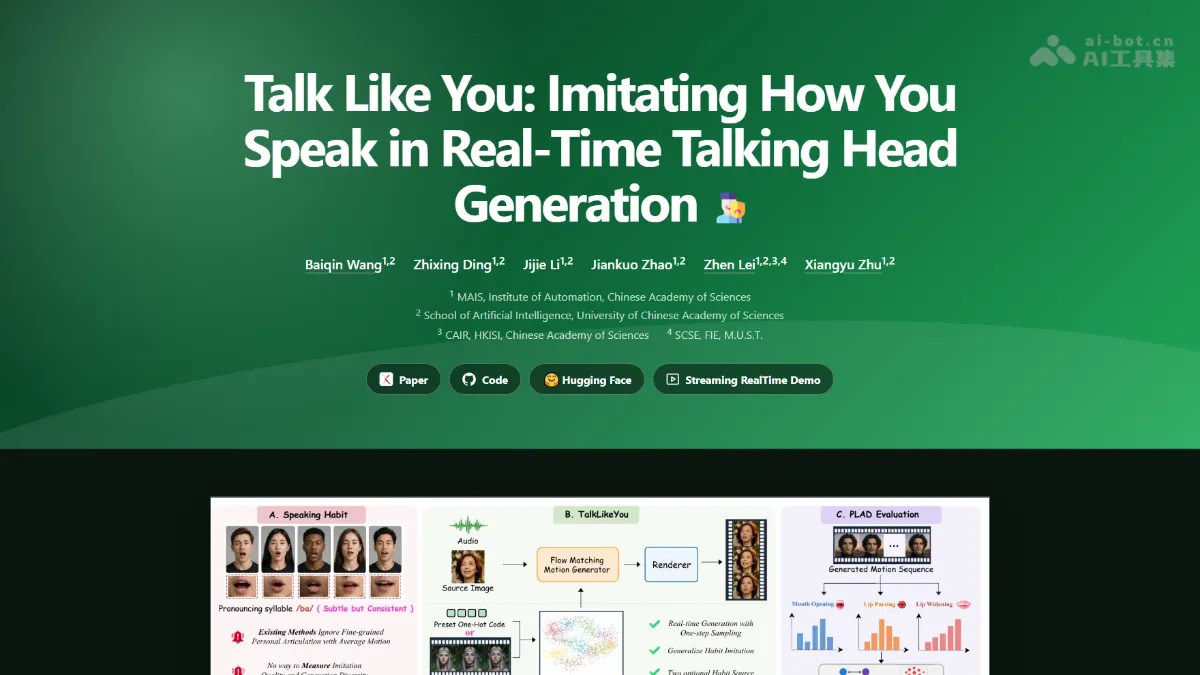
TalkLikeYou 是中科院自动化所开源的实时数字人框架,给一张照片和一段音频,能让照片里的人开口说话,嘴部动作能模仿指定真人的说话习惯。TalkLikeYou通过运动空间建模和一步采样实现实时生成,支持预设编号或参考视频来定制习惯,提出专用指标量化模仿相似度,代码权重全部开源。
TalkLikeYou的主要功能
- 照片说话 :上传一张人像照片和一段音频,可生成人物开口说话的视频。
- 习惯模仿 :可模仿指定真人的嘴部说话习惯,通过预设编号或4秒参考视频指定。
- 实时生成 :采用一步采样技术,生成速度达32.43 FPS,支持实时流式输出。
- 视频配音 :可替换视频中人物的嘴部动作,保留原有头部动作和时序,适合多语言配音。
- 对话数字人 :接入大模型和语音识别合成后,可实现实时对话交互的数字分身。
- 风格化驱动 :支持驱动素描、油画、动漫、3D角色等非真人风格的人像。
TalkLikeYou的技术原理
- 运动空间建模 :不同于直接在像素空间生成图像,TalkLikeYou 先将照片解析为运动参数,在这组轻量数字上学习和生成说话动作,由渲染器合成回视频,兼顾速度与身份稳定性。
- 一步 Flow Matching 采样 :用 Flow Matching 学习从噪声到目标的直线路径,配合重参数化直接预测干净的运动序列,一步采样可达到接近 50 步的唇同步质量,实现 32.43 FPS 的实时速度。
- 统一习惯空间 :构建可插值的低维习惯向量空间,将数据集中真人的嘴部运动统计压缩为 one-hot 编码,参考视频则通过习惯提取器编码进同一空间,两种入口可自由切换甚至插值混合。
- 两阶段训练策略 :先在 380 人规模的 HDTF 上用 one-hot 编码学习什么是习惯,再在大规模 CelebV-HQ 上改用参考视频训练泛化能力,周期性回放 one-hot 数据防止遗忘,使习惯相似度从 0.33 提升至 0.64。
- PLAD 评估指标 :将嘴部运动投影到张嘴幅度、嘴唇收拢、嘴唇拉宽三个发音轴,用分布直方图对比参考人计算相似度,首次为说话习惯像不像提供量化标准。
如何使用TalkLikeYou
- 环境准备 :用 Linux 系统,安装 Python 3.10 + CUDA 12.1 + FFmpeg,确保 NVIDIA 显卡显存至少 12GB。
- 下载代码 :从 GitHub 克隆 TalkLikeYou 主仓库。
- 安装依赖 :运行 conda env create -f environment.yaml 创建环境并激活,或自行安装 CUDA 版 PyTorch 后执行 pip install -r requirements.txt 。
- 下载权重 :通过 Hugging Face 命令 hf download doubi-killer/TalkLikeYou 将模型权重下载到仓库根目录。
- 准备素材 :准备一张人像照片(或视频)和一段音频,输入视频需为 25 FPS。
- 运行推理 :执行 python -m talklikeyou --source 照片 --audio 音频 --person-id 192 --sampling-steps 1 生成视频,换 --person-id 即换说话习惯。
- 自定义习惯 :将 --person-id 替换为 --habit-reference 指向一段至少 100 帧的参考视频,即可模仿该视频中人物的说话习惯。
- 视频配音 :将 --source 指向视频文件并添加 --pose-mode source ,只替换嘴部动作并保留原始头动。
TalkLikeYou的核心优势
- 说话习惯专属模仿 :业内首个将个人嘴部说话习惯作为一等公民建模的开源框架,可通过编号或视频指定,摆脱千人一面的平均嘴。
- 实时速度快 :一步 Flow Matching 采样实现 32.43 FPS,比图像扩散路线的 Sonic快近百倍,且单张 RTX 3090 显存占用不足 4GB。
- 画质与同步兼优 :FID 7.71 不到第二名三分之一,Sync-C 8.73 全场最高,兼顾唇部同步与画面质量。
- 习惯相似度领先 :PLAD 指标习惯相似度 0.62,显著高于 MimicTalk(0.48)、PC-Talk(0.39)等竞品。
- 两入口灵活定制 :支持官方预设编号零成本切换风格,支持任意参考视频现学,可插值创造新习惯。
TalkLikeYou的项目地址
- 项目官网 :https://bq-wang0511.github.io/TalkLikeYou/
- GitHub仓库 :https://github.com/BQ-Wang0511/TalkLikeYou
- HuggingFace模型库 :https://huggingface.co/doubi-killer/TalkLikeYou
- arXiv技术论文 :https://arxiv.org/pdf/2610.06658
TalkLikeYou的同类竞品对比
对比维度 | TalkLikeYou(中科院自动化所) | SoulX-LiveAct(Soul AI Lab)
| 对比维度 | TalkLikeYou(中科院自动化所) | SoulX-LiveAct(Soul AI Lab) |
|---|---|---|
| 核心定位 | 实时说话头生成 + 个人说话习惯模仿 | 实时数字人 + 小时级长时稳定生成 |
| 技术路线 | 运动空间两阶段(轻量参数 + 渲染) | 自回归扩散(AR Diffusion),像素级生成 |
| 核心技术 | 一步 Flow Matching、统一习惯空间、两阶段训练 | Neighbor Forcing(同扩散步对齐相邻帧)、ConvKV Memory(恒定显存) |
| 生成速度 | 32.43 FPS | 20 FPS(双卡 H100/H200) |
| 端到端延迟 | 未明确披露(流式缓冲可调) | 0.94 秒 |
| 时长上限 | 片段级生成(无长时优化) | 小时级甚至无限时长,显存恒定 |
| 说话习惯 | ✅ 支持(编号 / 参考视频 / 插值) | ❌ 不建模个人嘴部习惯 |
| 动作范围 | 仅嘴部 + 头部姿态 | 全身动作,表情、手势、情绪均可控(比心、捂脸、大笑) |
| 驱动方式 | 音频驱动(照片/视频) | 图像 + 音频 + 文本指令驱动 |
TalkLikeYou的应用场景
- 虚拟主播/直播带货 :低成本打造具有个人说话习惯的虚拟主播,4GB 显存可本地实时运行,无需真人出镜。
- 多语言视频配音 :替换视频中人物的嘴部动作并保留原有头动时序,让译制片或出海内容的口型与目标语言自然匹配。
- 数字分身/虚拟客服 :结合大模型与语音合成构建实时对话分身,应用于在线客服、智能导览等需要面对面交互的场景。
- 个性化教育/培训 :为教师或培训师创建专属数字形象,复刻其独特的说话风格,用于录制课程或远程教学。
相关工具
与本文相关的 AI 工具