QwenGyre 阿里千问推出的在线强化学习框架
QwenGyre是什么
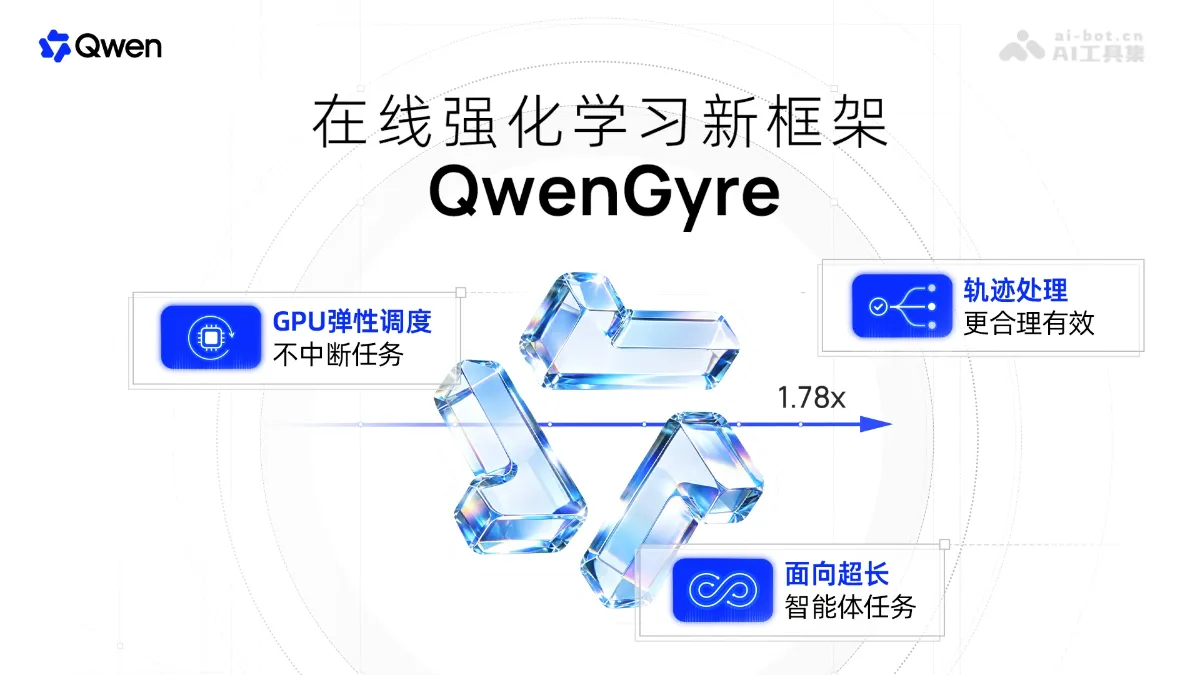
QwenGyre 是阿里千问推出的超长程智能体在线强化学习框架,面向单次约 70 万 token、持续数小时的任务。QwenGyre用弹性调度在任务不中断时把空闲 GPU 在采样与训练间切换,用轨迹处理保留真实上下文、评估部分成果、去重共享前缀以控制成本。在 Qwen3.8-2.4T 上 48 步把 NL2RepoBench 通过率从 52.48% 提至 58.54%,较 Async 端到端加速 1.78×。
QwenGyre的主要功能
超长程智能体在线强化学习 :在单次执行长达数小时、累计约百万 token 的任务上直接做 RL 训练。
弹性 GPU 调度 :任务不中断的情况下,动态把空闲 GPU 在采样与训练间切换。
请求重路由与 KV cache 迁移 :切换 GPU 角色时智能体继续运行,工作区和工具状态保留,通过 RDMA 迁移 KV cache 减少重复计算。
流式训练与新节点中途加入 :核心 cell 保存权威参数,卫星 cell 可随时拉取快照加入正在进行的批次,按进度领取微批次。
轨迹树与真实上下文保留 :用 Token-in Token-out 记录每次调用的精确输入输出,按共享前缀组织成轨迹树,输出始终对应生成时的上下文。
部分评分(Partial Scoring) :超时未完成的任务若产出可检验成果,仍按任务规则评分并用于训练。
轨迹预算与损失均衡 :每个执行最多保留 Jmax 条轨迹,共享前缀只计一次损失,避免分支多的任务权重过大。
QwenGyre的技术原理
弹性调度(Elastic Scheduler) :将 GPU 划分为若干同构计算单元,每个 cell 能用 SGLang 提供采样服务,也能用 Megatron 承载完整训练副本。调度器跟踪水位,未完成任务量,只要剩余采样容量足以支撑在跑任务且训练数据供应充足,就按序把 cell 逐个切入训练;切换时由代理把模型请求重定向到新推理引擎并重试未完成请求,后端进程和通信组无需重建。核心 cell 持有权威权重与优化器状态,卫星 cell 通过 RDMA 拉取参数快照后加入当前批次的梯度累计,最后由核心统一汇总更新,实现训练随数据就绪逐步扩容、采样与训练高度重叠。
轨迹处理(Trajectory Processor) :QwenGyre 通过代理记录每次模型调用的精确输入/输出 token ID 和行为策略对数概率,把共享前缀复用、分叉处建分支,组织成轨迹树,保证每条输出始终对应其生成时的原始上下文。训练准入阶段按角色优先级为每个执行选取不超过 Jmax 条轨迹,仅策略模型生成的 token 参与损失、共享目标只计一次;损失先在执行内对选中 token 取平均、再对执行取平均,使执行权重与其分支数量解耦。配合 Partial Scoring 对超时任务的已完成部分评估打分,最大化利用超长程执行中稀疏而昂贵的有效信号。
如何使用QwenGyre
目前 QwenGyre 用论文形式发布,阿里尚未公开代码与安装包。
QwenGyre的核心优势
首次实现旗舰模型超长程在线 RL :在 Qwen3.8-2.4T 上完成单次约 70 万 token 任务的在线强化学习,48 步将 NL2RepoBench 通过率从 52.48% 提升至 58.54%。
训练效率大幅提升 :相同 GPU 预算下端到端加速最高达 1.78×(对 Async)、1.85×(对 Colocate),48 步训练耗时从 134.55 小时缩短至 75.42 小时。
任务零中断的弹性调度 :GPU 在采样与训练间动态切换时,智能体执行、工作区和工具状态完全保留,切换耗时仅数秒,相对数小时的执行可忽略。
GPU 利用率最大化 :细粒度 cell 级资源分配消除了 Colocate 模式的长尾等待空转和 Async 模式的固定分区僵化,训练可被采样完全隐藏。
真实上下文保真训练 :TITO 机制保证每条输出都对应其生成时的原始上下文,避免历史压缩、子智能体上下文拼接导致的虚假上下文训练信号。
QwenGyre的项目地址
arXiv技术论文 :https://arxiv.org/pdf/2609.33848
QwenGyre的应用场景
自然语言生成完整代码仓库 :根据自然语言规格从零构建多包软件仓库,单次执行约 70 万 token、长达数小时。
已有仓库的长程软件工程 :在现有代码库中完成功能开发、缺陷修复与跨文件改造等复杂任务。
多轮终端自动化操作 :智能体在命令行环境中连续执行数百轮工具调用,完成系统配置与运维任务。
大规模代码库重构迁移 :跨仓库技术栈升级、整体重构等需要数小时连续规划执行的工程任务。
多智能体协作任务 :主智能体委派子智能体的层级执行场景,轨迹处理可利用分叉结构控制子任务训练成本。