MiDashengLM-Spatial 小米开源的空间音频理解大模型
MiDashengLM-Spatial是什么
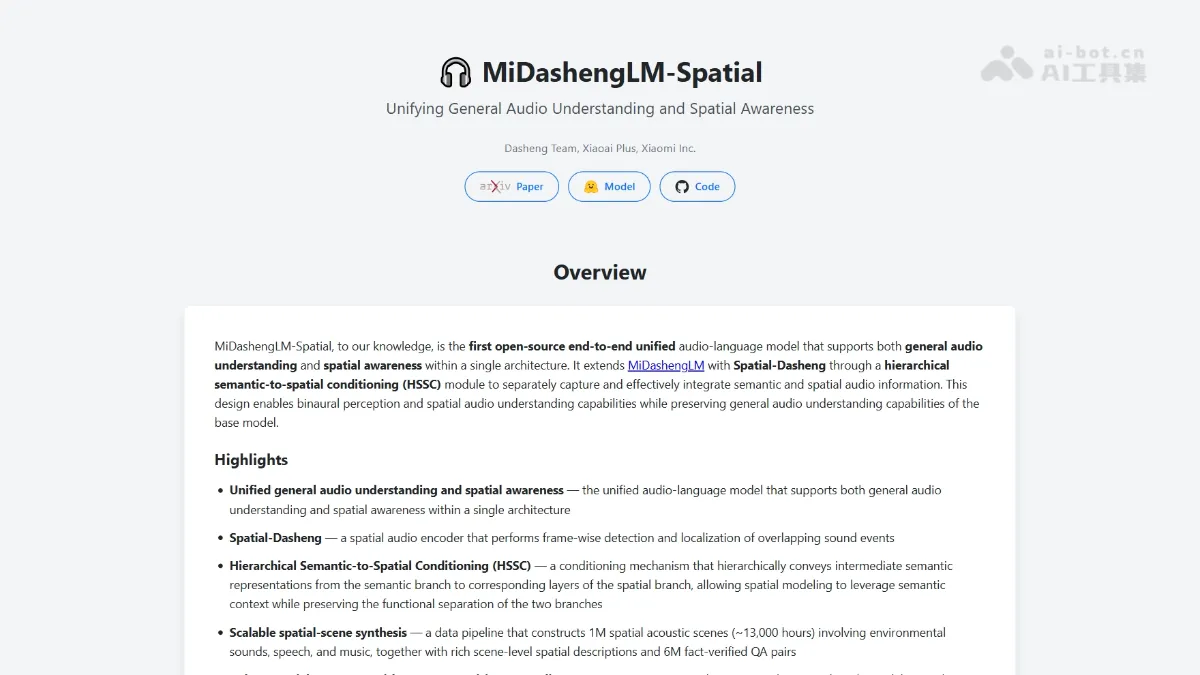
MiDashengLM-Spatial是小米Dasheng团队开源的空间音频理解大模型,业界首个在单一架构内统一通用音频理解与空间感知的端到端模型。MiDashengLM-Spatial以MiDashengLM-7B为基座,新增Spatial-Dasheng编码器和层级语义到空间条件模块,可感知声源方位、运动轨迹及多声源时空关系,支持重叠声源逐帧定位。配套1M空间场景与6M条QA训练数据,Apache 2.0许可发布,将落地智能家居与汽车座舱。
MiDashengLM-Spatial的主要功能
- 声源定位 :判断声音来自左侧、右侧还是正前方。
- 运动轨迹感知 :感知声源在空间中移动的方向与路径。
- 群组时空关系推理 :推理多个声源间的相对空间位置关系,如谁更靠左、是否同侧。
- 空间化内容理解 :结合听到了什么与声音来自哪里回答问题,如判断哪位说话者先点餐。
- 空间音频描述 :开放式生成场景中所有声源的位置、运动及时间关系的完整描述。
- 空间语音转写 :按说话顺序转写内容,并标注每个说话人的方位。
MiDashengLM-Spatial的技术原理
- 统一双分支架构 :模型以 MiDashengLM-7B 为基座,扩展出 Spatial-Dasheng 空间音频编码器,形成语义支路与空间支路并行的结构,分别负责听懂内容和感知方位,在单一模型内同时实现通用音频理解与空间感知。
- Spatial-Dasheng 编码器 :基于双耳输入,对重叠声源进行逐帧检测与定位,捕捉 ITD/ILD 等双耳线索,实现声源方位与运动轨迹的细粒度空间建模。
- 层级语义到空间条件(HSSC) :一种条件机制,将语义支路中间层的表征逐级传递给空间支路的对应层,使空间建模可以借助语义上下文,同时保持两支路功能上的独立分离。
- 可扩展空间场景数据管线 :通过仿真构建 100 万个空间声学场景,覆盖环境声、语音、音乐,并自动生成场景级空间描述与 600 万条事实验证 QA 对,支撑空间能力的规模化训练。
- Sim-to-Real 泛化 :合成数据训练的模型对真实双耳录音表现出稳健的空间感知能力,且在获得空间能力的同时不损失基座的通用音频理解性能。
如何使用MiDashengLM-Spatial
- 克隆代码仓库 : git clone https://github.com/xiaomi-research/midashenglm-spatial.git 。
- 创建推理环境并安装依赖 : conda create -n midashengspatial python=3.13 -y conda activate midashengspatial ,然后 pip install -r requirements.txt 。
- 获取模型权重 :无需单独下载,代码会自动从 HuggingFace 拉取 mispeech/midashenglm-spatial 。
- 准备双耳音频 :输入 (2, T) 双声道真实双耳音频。
- 加载模型与处理器 :用 AutoModelForCausalLM 和 AutoProcessor 以 trust_remote_code=True 加载模型。
- 构造对话消息 :按先音频后文本的训练顺序组织 messages,例如音频 + Write a general audio caption describing the sound source and its spatial information.。
- 执行推理 :通过 processor.apply_chat_template 处理输入后调用 model.generate ,再 batch_decode 输出结果。
- 参考示例运行 :仓库中的 example/inference.py 提供可直接运行的完整示例。
MiDashengLM-Spatial的核心优势
- 业界首创 :首个开源的端到端统一音频-语言模型,在单一架构内同时支持通用音频理解与空间感知。
- 空间感知能力顶尖 :在 STAR-Bench 空间推理子集上准确率达 70.3%,接近人类水平的 73.7%,远超 Gemini-3.6-Flash 的 47.0%。
- 感知真实可靠 :Channel-Swap ACR 达 72.6%,证明其左右方位判断基于真实听觉线索。
- 能力无折损 :在单声道音频问答、语音识别、音频描述等通用基准上成绩与基座 MiDashengLM-7B 基本持平,空间能力不牺牲通用性。
- 重叠声源解析 :Spatial-Dasheng 编码器支持对重叠声源进行逐帧检测与定位,可处理真实场景中多人同时说话等复杂情况。
MiDashengLM-Spatial的项目地址
- 项目官网 :https://jinbo-hu.github.io/midashenglm-spatial-demo/
- GitHub仓库 :https://github.com/xiaomi-research/midashenglm-spatial
- HuggingFace模型库 :https://huggingface.co/mispeech/midashenglm-spatial
- arXiv技术论文 :https://arxiv.org/pdf/2610.11156
MiDashengLM-Spatial的同类竞品对比
对比维度 | MiDashengLM-Spatial-7B | BAT-7B
| 对比维度 | MiDashengLM-Spatial-7B | BAT-7B |
|---|---|---|
| 架构定位 | 双分支架构:语义编码器 + Spatial-Dasheng 空间编码器 + HSSC 条件模块 | 单一架构处理双耳输入 |
| 空间推理准确率(STAR-Bench) | 70.3% | 0.0% |
| 空间问答准确率(MMAU-Pro 空间子集) | 55.4% | 23.7% |
| 整体理解分数(MMAU-Pro 全量) | 56.4% | 24.8% |
| Channel-Swap ACR(方位感知真实性) | 72.6% | 7.4% |
| 通用能力保持 | 不牺牲基座通用音频理解,ASR/描述成绩稳定 | 整体能力较弱 |
| 重叠声源处理 | 支持逐帧检测与定位重叠声源 | 未专门优化 |
| 开源许可 | Apache 2.0(可商用) | 开源 |
MiDashengLM-Spatial的应用场景
- 智能座舱交互 :判断车内哪个座位的乘客在说话,实现分区语音识别与指令执行。
- 智能家居声学感知 :通过音箱/家居设备感知家中声响的方位与移动。
- AR/VR 空间音频 :为虚拟世界提供听觉层面的空间理解,实现声源定位、空间描述生成与沉浸式交互。
- 助听与无障碍设备 :帮助听障人士感知声音来自哪个方向,增强环境感知与出行安全。
相关工具
与本文相关的 AI 工具