GO-3 Preview 智元机器人推出的具身智能模型
GO-3 Preview是什么
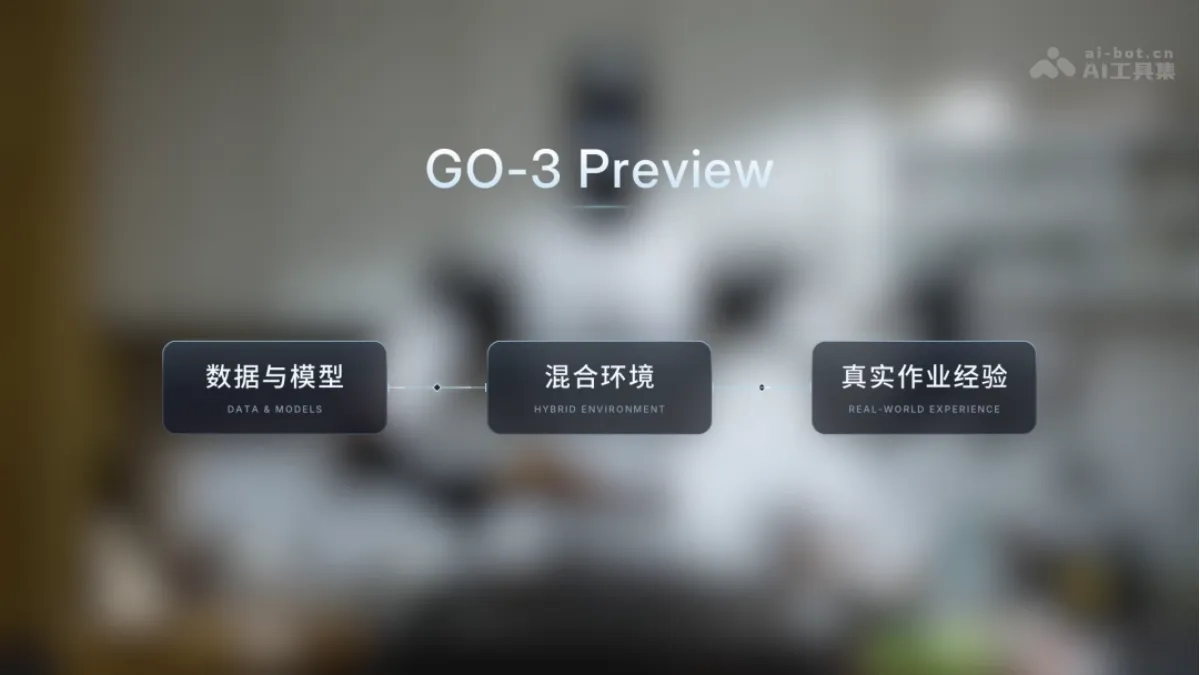
GO-3 Preview 是智元机器人推出的具身智能模型,特点是实现预训练、后训练、部署后全链路规模化学习。预训练阶段用 WRAM 架构从人类第一视角视频学技能,后训练通过 Genie Evolver 融合真机、仿真与世界模型反复练手,部署后借助 Genie Master 在真实作业中积累经验、持续自我进化。GO-3 Preview拿下 RoboDojo 等三项权威评测第一,已在便利店等场景落地验证,将在年底开源。
GO-3 Preview的主要功能
- 视频预训练学技能 :从海量人类第一视角视频中学习物理世界的状态变化与操作方法,具备数百种任务的开箱即用能力。
- 未来状态预测(WRAM 架构) :通过 CoAE 视觉表征、SVP 单步视觉规划器等模块,预测任务执行后的未来画面并转化为可执行动作。
- 虚实混合后训练(Genie Evolver) :结合真机集群、物理仿真和世界模型,让机器人在虚拟与现实中反复练习,快速提升复杂操作能力。
- 群体经验学习(CEL) :汇聚多台机器人的成败经验并更新共享策略,实现个体试错、群体受益。
- 任务规划与异常恢复(Genie Master) :作为具身 Agent 编排操作步骤、检查结果,任务中断时可保留进度并从断点重新规划。
- 部署后持续进化(Physical RSI) :将真实作业中的成功、失败与异常恢复数据回灌训练,在工作中持续积累经验、自我改进。
- 跨本体操作 :同一模型可在不同机器人本体上迁移执行抓取、开门、跪地取物等动作。
GO-3 Preview的技术原理
- 预训练 :GO-3 Preview 采用具身原生架构 WRAM,将任务理解 → 未来状态预测 → 动作生成串联为统一流程。 CoAE 模块从相机画面中提取物体位置、形态及相互关系等操作信息;SVP 单步视觉规划器根据当前观测和任务条件,一次前向计算预测多个未来时刻的视觉状态;逆动力学模型再结合机器人自身状态,将预测的状态变化转化为可执行动作。
- KASO :同一任务往往存在多种合理完成方式,预测出的未来状态不一定与真实动作相容。KASO通过生成多个候选未来,评估各预测结果与真实动作的相容程度,筛选更合适的样本参与联合训练,保证视觉预测与动作学习在训练中始终协调一致,避免两个目标相互干扰。
- 后训练 :后训练系统整合三类环境以扩大有效交互规模:真机集群提供可靠的物理反馈;物理仿真通过调整物体位置、摩擦系数、碰撞条件等参数,提供大量可重复的试错机会;世界模型则能在动作偏离目标时回溯到关键决策点,预测不同力度、角度可能带来的结果,将一次真实经历扩展为多种候选动作的探索起点。三类环境形成真机验证—仿真扩展—世界模型探索的闭环,共同驱动策略迭代。
- CEL 群体经验学习 :面对多机并行训练,CEL 通过检索成功动作片段、分析失败上下文并更新共享策略,将分散在百台级真机集群中的个体经验汇聚为群体知识。其效果是系统级的规模收益:实验显示,在同等训练时间下,随着参与学习的真机数量增加,手机包装任务成功率从 50.8% 提升至 98.3%,说明学习收益能随机器人。
如何使用GO-3 Preview
GO-3 Preview 目前尚未开源。
GO-3 Preview的核心优势
- 全链路规模化学习 :打通预训练、后训练、部署后三个阶段,机器人从看视频学技能到上岗后自我进化形成完整成长闭环。
- 视频预训练效率高 :约九成数据来自人类第一视角视频,覆盖场景和技能远超机器人示范数据,大幅提升技能获取的广度与成本效率。
- 预测与动作协同(WRAM + KASO) :能预测物理状态变化,又能将预测与真实动作对齐,解决看得懂但做不准的问题。
- 虚实混合训练降本增效 :真机、仿真、世界模型三类环境分工协作,扩大交互经验规模的同时减少真实试错带来的设备损耗与安全成本。
- 规模化的群体学习收益 :CEL 机制让真机规模扩大直接转化为性能提升,学习效果具备可扩展性。
GO-3 Preview的项目地址
GO-3 Preview 将于 2026 年底全面开源。
GO-3 Preview的同类竞品对比
对比维度 | GO-3 Preview(智元) | UnifoLM-WLA-1.0(宇树)
| 对比维度 | GO-3 Preview(智元) | UnifoLM-WLA-1.0(宇树) |
|---|---|---|
| 模型规模 | 未公开(另有轻量版 GO-3 Nano Preview) | 6B 参数 |
| 技术架构 | WRAM(世界推理动作模型):CoAE 视觉表征 + SVP 未来状态预测 + 逆动力学动作生成 | WLA(世界-语言-动作融合):以交互为中心的世界建模,统一动作空间实现感知、预测、动作协同 |
| 训练数据 | 约 90% 人类第一视角视频 + 真机/仿真/世界模型混合数据 | 约 2,500 小时高质量真机数据(含自有开源数据、BitRobot-HIW-500 公开数据) |
| 任务覆盖 | 数百种任务开箱即用,覆盖桌面精细操作到跨本体全身任务 | 单模型统筹 64 项任务(10 项全身移动 + 54 项桌面操作) |
| 后训练体系 | Genie Evolver:真机集群 + 仿真 + 世界模型混合环境,CEL 群体经验学习 | 提供微调工具链,无混合环境与世界模型回溯机制 |
| Agent 能力 | Genie Master:任务规划、断点续做、异常恢复、经验记忆一体化 | 无内置 Agent 框架 |
| 部署后学习 | 支持 Physical RSI:真实作业经验回灌训练,已在便利店闭环验证 | 不支持,模型更新依赖离线迭代 |
| 评测成绩 | RoboDojo、RoboTwin、RoboColiseum 三榜第一 | 多项具身推理评测刷新开源模型 SOTA,官方称可比肩头部闭源模型 |
GO-3 Preview的应用场景
- 便利店零售补货 :精灵 G2 已在真实便利店部署验证,可完成识别商品、规划顺序、抓取摆放等补货任务,并在出现滑落、遮挡等异常时自主调整、断点续做。
- 熟食打包与外卖封装 :在便利店场景中完成熟食打包、外卖装袋等精细操作,能处理水瓶被提带缠绕等异常,并将恢复经验沉淀回模型持续改进。
- 工业制造装配 :真机集群实验中的手机包装任务已实现 98.3% 成功率,多阶段长流程失败次数下降 92%,适用于 3C 产品的装配、检测、包装产线。
- 展厅交互与科教演示 :乐高连续拼装、桌面冰壶对战、抽积木等任务展示了其精细操作与长程决策能力,适合科技馆演示、人机互动体验和科研教学场景。
相关工具
与本文相关的 AI 工具