DeepInfer DeepSeek 开源的生产级推理框架
DeepInfer是什么
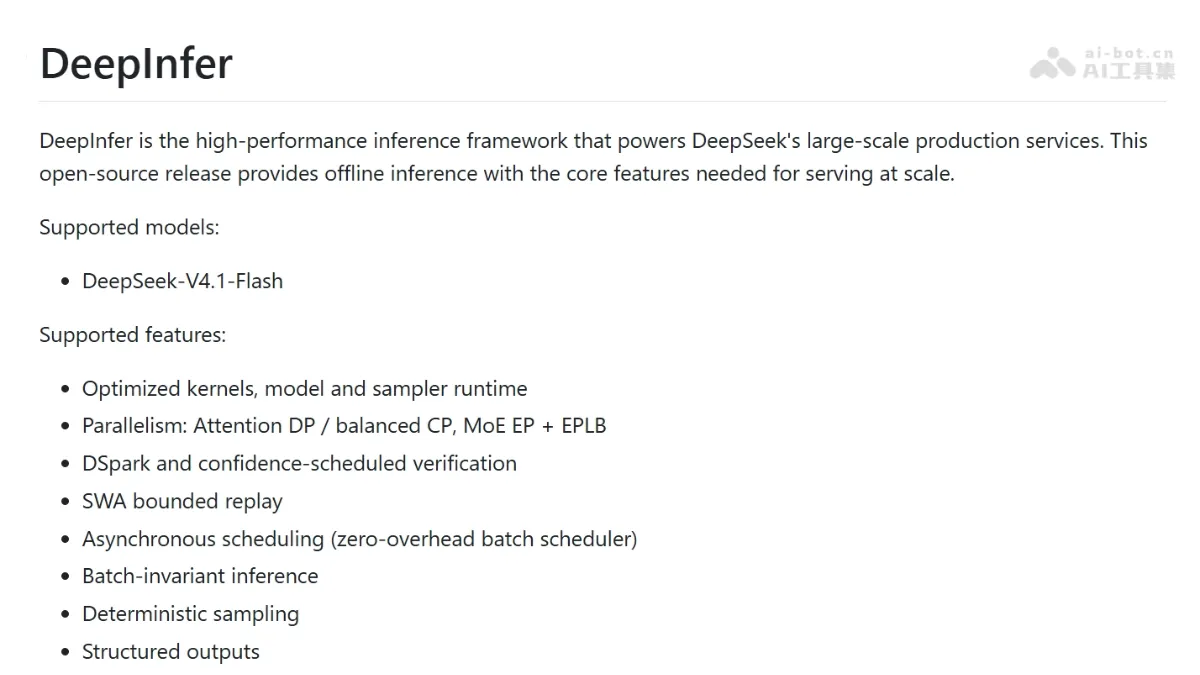
DeepInfer 是 DeepSeek 开源的生产级推理框架,源自 vLLM,支持 V4.1 Flash,可运行于英伟达 SM100 与华为昇腾 950。DeepInfer 采用 PD 分离部署,靠 3FS 缓存集群实现 96% 输入命中、Prefill 提效 25 倍,SWA Bounded Replay 令 Prefill 计算量减半,DSpark 投机解码再提吞吐 6%,线上单集群日处理 155 万亿 Token。同步开源的 deepseek-recipe是生产级 Token 编解码组件,负责统一 Chat Completions、Responses、Messages 三种 API 格式,处理注入防护、并行分词与流式输出,使自部署模型的接口表现与官方 API 完全一致。
DeepInfer的主要功能
分布式推理 :支持注意力数据并行、上下文并行及 MoE 专家并行,支撑单集群日处理 155 万亿 Token 的大规模生产服务。
跨硬件平台兼容 :同时支持英伟达 SM100 GPU 与华为昇腾 950 NPU,覆盖两大算力生态。
长上下文高效处理 :通过 SWA Bounded Replay 将缓存未命中的重算成本压缩到固定 128 个 Token,与上下文长度和层数解耦。
推测解码加速 :集成自研 DSpark 与置信度验证调度,让模型一次推进多个 Token,显著提升生成吞吐。
负载均衡调度 :动态均衡专家与请求的分布,线上最繁忙的卡仅高出平均负载 9%。
缓存复用 :依托 3FS 存储集群实现 96% 的输入缓存命中率,Prefill 吞吐提升约 25 倍。
DeepInfer的技术原理
PD 分离部署 :推理分为 Prefill 与 Decode 两个阶段:Prefill 一次性处理数万 Token 的输入,是计算密集型;Decode 逐 Token 生成,受限于显存带宽读取。DeepInfer 将两者部署在不同硬件上,Prefill 用常规 8 卡服务器,Decode 用 64–128 卡超节点,两类机器数量按约 1:1 配置,使各自按最优硬件特性运行。
前缀缓存体系 :Agent 场景下每次工具调用都会重发完整历史,其中大部分内容已计算过。系统只缓存从首 Token 起完全一致的前缀,命中部分直接复用 KV Cache,仅计算新增部分。缓存存放于独立的 3FS 分布式存储集群,用 128 Token 为块写入,Agent 流量保留 3 天、聊天流量保留 7 天。
SWA Bounded Replay :V4.1 Flash 的部分层采用滑动窗口注意力,每个 Token 只关注最近 128 个 Token,这部分 KV Cache 不写入硬盘、仅驻留在计算机器的内存中。未命中时旧方案需按层数 × 窗口长度精确重算,V4.1 改为只重算最后 128 个 Token、且注意力仅在这 128 个内计算,得到近似窗口缓存,重算成本固定。
DSpark 推测解码与异步调度 :由轻量草稿模块先连续猜测 5 个 Token,再由目标模型批量验证,猜对的直接采用、首个猜错处由大模型纠正,一步计算即可推进多个 Token。置信度头预估各猜测被接受的概率,低可能性的不再验证、把算力让给其他请求,相比固定验证 5 个的方案线上吞吐提升 6%。同时 CPU 调度第 N+1 步与 GPU 计算第 N 步重叠执行,消除 GPU 在调度间隙的空转。
如何使用DeepInfer
确认环境前置条件 :Linux 系统,GCC ≥ 13.0、Python 3.12,NVIDIA 平台需 CUDA 13,昇腾平台需 CANN 9.2。
克隆仓库 : git clone https://github.com/deepseek-ai/DeepInfer 并进入目录。
创建干净环境 :新建并激活一个空的 Python 3.12 虚拟环境,避免依赖冲突。
选择硬件平台并编译 :运行 export DEEPINFER_ACCELERATOR=nvidia (昇腾用 ascend )后执行 ./build.sh 从源码构建,注意该环境变量需在后续运行环境中保持生效。
准备模型权重 :默认首次运行会自动从 Hugging Face 下载 deepseek-ai/DeepSeek-V4.1-Flash-1017 ,或用 export DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017 指向本地副本。
运行离线推理示例 :执行 python examples/offline_inference.py 启动推理,更多用法参考仓库 examples 目录。
DeepInfer的核心优势
经过生产验证的超高性能 :已在 V4.1 Flash 大规模线上服务中实际运行,单集群日处理 155 万亿 Token,首字延迟仅 400ms,生成速度 230 tokens/s。
极高的缓存复用效率 :96% 的输入命中前缀缓存,Prefill 每卡吞吐从不计缓存的 6 万提升至 150 万 tokens/s,相差 25 倍。
长上下文成本大幅降低 :SWA Bounded Replay 将缓存未命中的重算量固定为最后 128 个 Token,使 Prefill 总计算量近乎减半,且成本与上下文长度无关。
生成效率行业领先 :DSpark 推测解码叠加置信度调度与异步调度,一步可推进多个 Token,线上吞吐相比固定验证方案再提升 6%,每卡每秒生成 14K Token。
卓越的负载均衡能力 :MoE 专家副本每 10000 步动态重排,线上最忙的卡仅高出平均负载 9%,整体达到理想均衡状态的 80%。
双硬件平台兼容 :同时支持英伟达 SM100 GPU 与华为昇腾 950 NPU,是目前极少数覆盖两大算力生态的生产级推理框架。
DeepInfer的项目地址
GitHub仓库 : https://github.com/deepseek-ai/DeepInfer
https://github.com/deepseek-ai/deepseek-recipe
DeepInfer的同类竞品对比
维度 | DeepInfer | vLLM
维度 | DeepInfer | vLLM |
|---|---|---|
定位 | DeepSeek 模型的生产级推理框架 | 通用大模型推理与服务框架 |
模型支持 | 目前仅 DeepSeek V4.1 Flash | 几乎所有开源模型(数百种) |
硬件支持 | 英伟达 SM100、昇腾 950 | 英伟达全系 + AMD/昇腾/TPU 等 |
核心优化 | DSpark 推测解码、SWA Bounded Replay、96% 缓存命中 | PagedAttention、Continuous Batching、Prefix Caching |
性能水平 | 单集群日处理 155 万亿 Token,每卡 14K tokens/s(Decode) | 生态主流基准,通用场景性能优秀 |
生产验证 | DeepSeek 官方线上大规模服务 | 全球大量企业线上部署,生态最成熟 |
API 对齐 | 配合 deepseek-recipe 可完全对齐官方 API | 支持 OpenAI 兼容 API |
服务化能力 | 开源版仅离线推理 | 完整的在线服务、API 服务、集群调度 |
生态与社区 | 刚开源,社区起步 | 最活跃的推理框架社区,插件丰富 |
适用场景 | 自部署 DeepSeek 模型、追求官方级性能 | 多模型通用部署、快速上线的服务场景 |
DeepInfer的应用场景
企业私有化部署 :企业在本地数据中心部署 V4.1 Flash,借助 deepseek-recipe 对齐官方 API 行为,实现数据不出域的合规推理。
国产化算力适配 :原生支持华为昇腾 950 NPU,满足政企、金融等信创场景摆脱英伟达依赖的需求。
大规模 Agent 服务 :96% 前缀缓存命中率大幅降低多轮工具调用的重复计算,适合高并发 Agent 平台低成本运营。
长上下文文档处理 :SWA Bounded Replay 将长文本 Prefill 计算量近乎减半,适合合同分析、代码库理解等超长输入场景。
高性价比自建推理服务 :每卡高吞吐 + 230–300 tokens/s 生成速度,适合创业公司替代按量付费 API,规模化自建省钱。