Agensh 微软研究院推出的多智能体协作框架
Agensh是什么
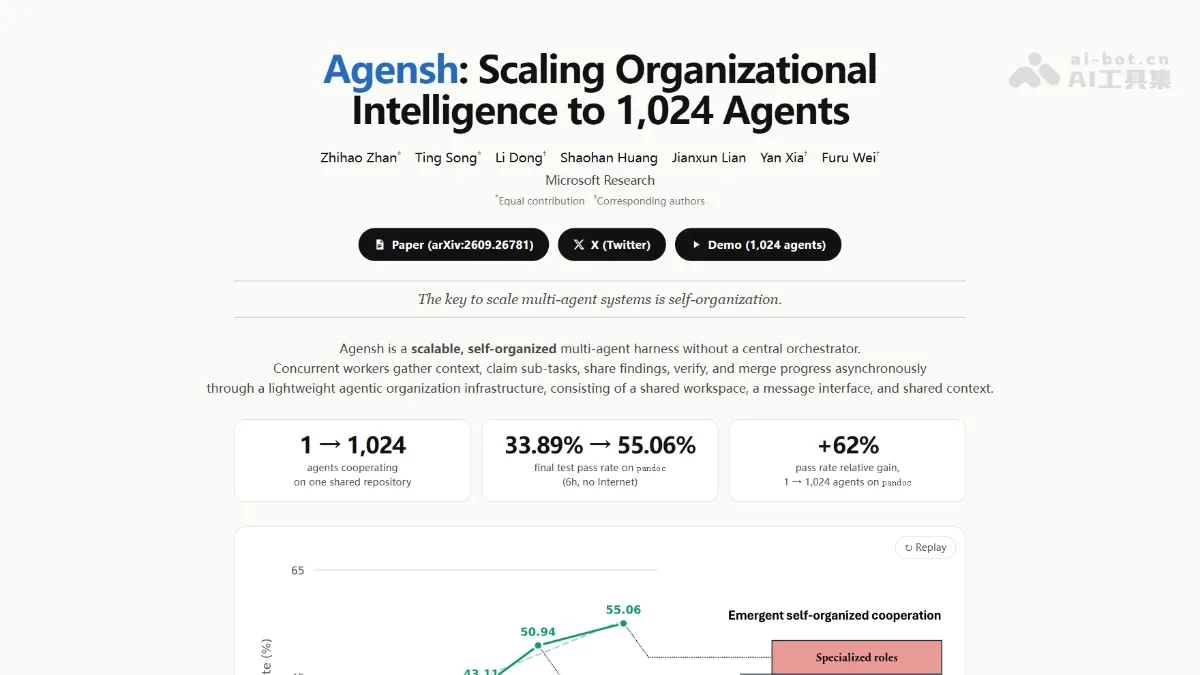
Agensh是微软研究院推出的多智能体协作框架,所有智能体遵循统一的五步协作循环,通过共享代码仓库、即时消息和结构化看板自组织分工。实验表明,在模型不变的前提下,从1个扩展到1024个智能体,软件复现测试通过率从33.89%提升至55.06%,证明智能体数量本身可成为扩展AI能力的新维度。
Agensh的主要功能
无中心编排 :去掉主管智能体,所有智能体自主认领任务、协商分工、合并成果。
五步协作循环 :每个智能体重复执行收集上下文→认领子任务→执行分享→验证结果→合并进展的异步循环。
共享工作区 :基于 Git(Gitea)管理代码,支持并发开发、分支合并与冲突暴露。
消息协商 :基于 Mattermost 实现团队公告与一对一私聊,私聊可即时打断对方解决任务碰撞。
共享上下文看板 :记录 OBSERVED/FACT/FAIL/CLAIM/PATCH_SUMMARY 五类条目,供全员复用经验、避免重复劳动。
千级规模扩展 :在实验中将智能体数量扩展至 1,024 个,仍能保持自组织协作不崩溃。
角色自发涌现 :组织规模扩大后,审查惯例、标准流程、专职整合者等分工自行形成,无需预设。
Agensh的技术原理
组织层与单智能体层解耦的分层架: Agensh 不替代底层单智能体框架,在其之上叠加组织层。每个智能体的本地循环由底层 harness负责,Agensh 只负责智能体身份、协作协议、事件路由、共享服务与故障恢复。两层接口刻意保持轻量即插即用,协作循环不硬编码在运行时中,通过 prompt 中的工作流指令实现,所有智能体收到完全相同的指令,适配不同底层框架只需更换轻量适配器,无需改动协作逻辑。
事件驱动的异步运行时 :每个智能体由配套的事件驱动而非中央调度:router 持续监听 Gitea 仓库活动和 Mattermost 消息,将新事件写入带唯一 ID 的去重持久化队列,由 dispatcher 在智能体的下一轮 turn 中合并排序后注入。消息按两级优先级投递:公共频道消息在循环开始时送达,直连消息和看板新条目会包装进当前 turn 的工具调用返回结果中途送达,使智能体在任务碰撞时能实时打断同伴协商。配套机制包括失败渐进重试、router 重启后的队列与会话恢复、智能体闲置 10 分钟自动唤醒、以及完成一轮未发看板条目时的补发提醒。
类型化共享上下文实现组织记忆 :借鉴 DeLM 的思路,Agensh 将组织记忆外置为 append-only 的结构化日志,条目分五种类型:OBSERVED 记录参考程序的可观察行为,FACT 记录已确认事实,FAIL 记录被证伪的假设,CLAIM 用于公开认领范围以防任务碰撞,PATCH_SUMMARY 以files= | idea= | evidence=的固定格式总结已完成修改。看板通过两种路径分发:新一轮 turn 开始时注入近期 2000 条记录,turn 中通过工具调用返回追加新条目;同时提供 board_grep 工具支持对全历史的 AND/OR 关键词检索,绕开单智能体上下文窗口上限,支撑长时程任务的经验积累与复用。
协作循环内置冲突解决与验证机制 :认领子任务时,智能体须在看板上发布 CLAIM 声明范围,一旦发现与他人重叠,双方通过私聊协商调整;合并阶段以 Git 为主干,智能体在私有分支开发后向主分支提交 PR,遇到合并冲突时需拉取最新进展、解决冲突后重新提交,且必须先对照验收标准验证本地结果才能合入。这套机制把传统上由主管承担的任务分配、冲突仲裁和成果整合三项职责,分散到全体成员的日常循环中,通过版本历史与 PR 流程把整合工作显式化、可追溯化。
如何使用Agensh
准备环境 :确保机器装有 Docker 及可用的模型 API。
克隆代码库 :从 GitHub 拉取 microsoft/Agensh 仓库到本地,等代码公开后 clone。
部署共享基础设施 :启动框架依赖的三类组件,Gitea(代码仓库)、Mattermost(消息通信)和共享上下文看板服务。
配置智能体参数 :在配置中设定 worker 数量、任务目标、时间预算,以及底层单智能体 harness 类型和模型密钥。
启动组织 :运行启动脚本,框架会按错峰策略逐批激活智能体,大规模部署自动分布到多节点。
智能体自主工作 :成员按五步循环自主认领任务、开发代码、发 PR、合并到主分支,无需人工干预,只需在 Mattermost 公共频道观察进度。
收尾与交付 :临近截止时间框架会自动提醒收敛,最终结果以主分支代码和看板记录交付。
Agensh的核心优势
突破主管瓶颈 :去掉中心编排器后,系统扩展性不再受单一智能体协调能力的上限约束,可平滑扩展至 1,024 个智能体。
数量成为新能力维度 :在模型和底层框架完全不变的前提下,仅靠增加智能体数量即可将平均测试通过率提升约 49%,开辟了模型规模之外的第二条 scaling 路径。
显著降低任务延迟 :128 个智能体在第 30 分钟即可超过 30% 通过率,而单智能体前两小时未达标,大团队能用更少时间达到同等成绩。
基础设施轻量且解耦 :协作循环通过 prompt 指令而非硬编码实现,可即插即用地适配 Copilot、Claude Code 等不同底层框架,共享服务仅需 Gitea、Mattermost 和看板三个开源组件。
组织经验可沉淀复用 :类型化看板将观察、事实、失败假设结构化记录,FAIL 类条目尤其能阻止同伴重复浪费预算,实现组织级记忆。
Agensh的项目地址
项目官网 :https://agens-harness.github.io/project/
arXiv技术论文 :https://arxiv.org/pdf/2609.26781
Agensh的同类竞品对比
对比维度 | Agensh(微软研究院) | Kimi Agent Swarm(月之暗面)
对比维度 | Agensh(微软研究院) | Kimi Agent Swarm(月之暗面) |
|---|---|---|
核心定位 | 研究框架:证明”智能体数量”是可独立扩展的能力维度 | 产品级能力:模型内置的并行执行模式,主打降低任务延迟 |
架构模式 | 完全去中心化,无中心编排器 | 编排器-工人结构,保留中央协调者 |
协作机制 | 智能体通过共享代码仓库、消息、看板自组织认领任务 | 编排器自主拆解任务、生成子智能体、汇总结果 |
智能体上限 | 已验证1,024 个(16 节点×64) | K2.5 时代 100 个/1,500 次工具调用;现由 K3 驱动,上限提至 300 个/4,000 步 |
并行能力来源 | 靠基础设施(Gitea/Mattermost/看板)+ prompt 级协作循环 | 靠强化学习训练:PARL 冻结子智能体、只训编排器 |
防失效设计 | CLAIM 声明防任务碰撞;FAIL 条目防重复浪费预算 | 三维奖励防”串行塌缩”和”伪并行”;Critical Steps 指标考核真实并行度 |
分工形成方式 | 自发涌现:整合者、审查惯例、标准流程随规模自然出现 | 编排器指派:角色由协调器按任务动态生成,无预设角色 |
验证场景 | 断网、6 小时从零复现大型软件(ProgramBench 最难 5 题) | 广度型任务:深度调研、批量数据处理、多模态抽取 |
核心成果 | 1→128 智能体平均通过率 +49%;128 个时 30 分钟即超 30% | 关键步骤减少 3~4.5×;BrowseComp 准确率 15.9%→33.3% |
扩展性瓶 | 收益递减(128→1024 仅 +4.12 个百分点);成本未公开 | 上限受编排器调度能力约束;强顺序依赖任务不适用 |
开放性 | 论文 + 代码开源(GitHub microsoft/Agensh) | 模型开源权重(修改版 MIT),编排器训练方法闭源 |
适用任务倾向 | 长时程、强耦合、需要持续整合的复杂工程任务 | 可分解、弱耦合、工具密集的广度型任务 |
Agensh的应用场景
大型软件行为复现 :在断网、限时条件下,让数百至上千智能体从零重建 FFmpeg、pandoc 等数十万行级软件的行为并通过隐藏测试。
高时效应急开发 :适用有硬时间预算的任务,128个智能体30分钟即可达到单智能体两小时无法企及的完成度。
超大规模代码审计 :智能体分工认领模块、并行编写测试、互相审查 PR,天然适配大型企业代码库的安全审计与测试覆盖扩展。
无预设方案的探索型研发 :当任务无法预先拆解时,智能体通过观察参考行为自行发现任务,适合需求模糊、边界靠探索确定的技术攻关。
跨领域基础软件移植 :PHP解释器、分子模拟等多领域系统开发中,群体智能可覆盖无人全才的知识面,同领域专家还能互为备份接力。